网心技术 | 编码 Agent 上下文管理:从运行时压缩到 Codegraph 的结构化检索
一、问题的本质:上下文窗口是编码 Agent 的硬性瓶颈
编码 Agent 系统,以 Claude Code、Cursor、Codex CLI 为代表。在过去两年从代码补全工具演化为能够自主规划、执行 Shell 命令、读写文件并迭代验证的自治系统。这一演进暴露了一个结构性矛盾:Agent 的能力边界不由模型智能决定,而由上下文窗口的容量决定。
SWE-bench 的更新评估框架将每个任务的 token 上限设为 200 万未缓存读写 token(加 2000 万缓存 token 读取)。输入 token 占总消耗的绝大部分,因为每次工具调用都需要将完整的对话历史重新注入 prompt,产生"上下文雪球效应":token 消耗随模型调用次数呈二次增长。SWE-Effi 的大规模评估进一步揭示了一个反直觉的事实:失败的任务比成功的任务消耗更多资源,以 SWE-Agent + GPT-4o-mini 为例,一次失败尝试消耗 886.7 万 token 和 658 秒,而成功尝试仅需 186.5 万 token 和 167.2 秒,两者差距超过 4 倍。
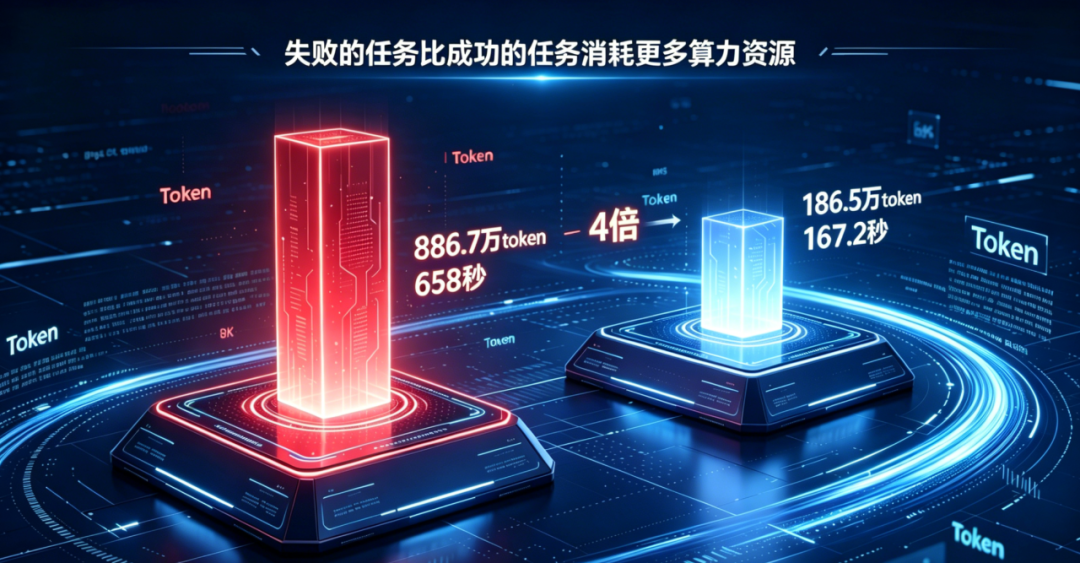
这一现象的根源在于模型对长上下文的利用效率。Liu et al. (2023) 的 "Lost in the Middle" 研究证实了一个关键发现:语言模型对上下文的利用呈 U 形曲线:信息位于上下文的开头或末尾时检索效果最佳,位于中间时性能显著下降。在包含 20 篇文档的输入中,GPT-3.5-Turbo 的 oracle 准确率为 88.3%,当相关信息位于中间位置时显著下降;GPT-4 虽然绝对性能最高,仍然展现出相同的 U 形曲线。这意味着更长的上下文窗口并不等于更好的性能;相反,更精确、更短的上下文往往使模型表现更强。
这三个因素:token 消耗的二次增长、失败任务的资源浪费、长上下文的利用效率衰减。共同构成了编码 Agent 的核心工程挑战:如何在有限的上下文窗口中维持最高的信息密度?
本文以 Claude Code 的五层压缩管线和 Codegraph 的结构化检索为主线,从源码层面分析两种互补的解法:事后压缩(在上下文膨胀后裁剪)和事前检索(在信息进入上下文前精确定位)。分析基于 arXiv:2604.14228 的源码级架构研究[1]、Anthropic 官方文档[5]、Codegraph 开源实现[6],以及六篇经同行评审的上下文管理论文。
二、Claude Code 的架构:Agent 循环与上下文管理的位置
2.1 核心循环:While-True 与 AsyncGenerator
Claude Code 的核心是一个以 async function* 定义的异步生成器循环[1][7]。每个 turn 的生命周期包含五个阶段:
状态初始化 → 上下文预处理(七步管线) → API 调用(流式接收) → 工具调用执行 → 工具结果回填。
queryLoop() 是一个 while(true) 无限循环,每次迭代代表一次"模型调用 + 工具执行"的完整回合。AsyncGenerator 的选择并非随意:yield 提供流式输出,使 UI 可以逐 token 渲染;.return() 提供确定性取消,确保 Ctrl+C 时所有资源被正确释放;yield* 提供子生成器委托,使工具执行的事件流可以无缝组合到主循环中。
VILA Lab 对 Claude Code v2.1.88(约 1900 个 TypeScript 文件、51.2 万行代码)的源码分析揭示了一个关键数据:仅 1.6% 的代码是 AI 决策逻辑,其余 98.4% 是确定性基础设施:权限门控、上下文管理、工具路由和恢复逻辑。上下文管理正是这 98.4% 中最复杂的子系统之一。
2.2 上下文窗口的组装顺序
在模型被调用之前,Agent 循环从以下来源组装上下文窗口(按加载时序排列)
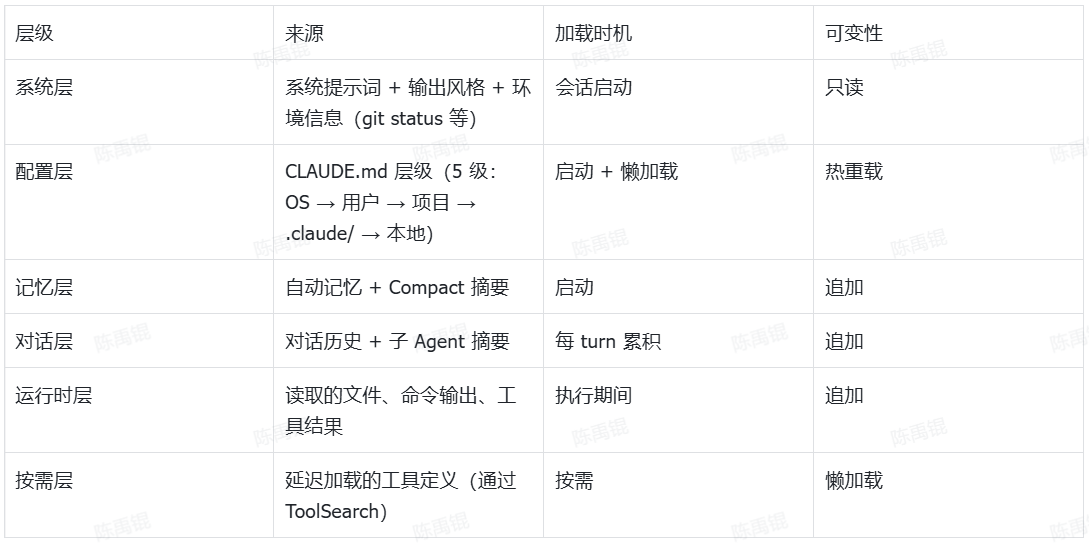
上下文窗口并非在组装完成后静态不变。在一个 turn 的执行过程中,相关记忆预取、MCP 指令增量、后台 Agent 任务通知都可能动态注入。对话层和运行时层随 turn 数单调增长,这正是压缩管线存在的原因。
三、五层压缩管线:渐进式退化的设计哲学
3.1 设计原则:从最轻量到最激进
Claude Code 的压缩管线在每次模型调用前执行,由五个按激进程度递增排列的策略组成:
Level 1: Budget Reduction(工具结果预算) → 零成本
Level 2: History Snip(历史裁剪) → 零成本
Level 3: Microcompact(细粒度缓存感知压缩) → 零 API 调用
Level 4: Context Collapse(上下文折叠) → 零成本,非破坏性
Level 5: Autocompact(自动压缩) → 一次 API 调用,不可逆
3.2 Level 1: Budget Reduction — 工具结果的硬性边界
applyToolResultBudget() 对每条工具结果施加大小限制。超出阈值(默认 50K 字符)的输出被持久化到磁盘,上下文中仅保留约 2KB 的预览摘要和内容引用。免除此限制的工具(maxResultSizeChars 为无穷大的工具)保留完整输出。
这一层类似于操作系统的分页机制:当数据过大无法放入内存(上下文窗口)时,将部分数据存储到磁盘,只保留摘要或引用。Budget Reduction 始终激活,是五层管线中唯一不受 feature flag 控制的策略。它在 Microcompact 之前运行,因为 Microcompact 仅通过 tool_use_id 操作,从不检查内容——两者可以干净地组合。
3.3 Level 2: History Snip — 时间维度的裁剪
snipCompactIfNeeded() 是一个轻量级的历史修剪策略,由 HISTORY_SNIP feature flag 门控。它移除较早的、过时的对话片段,返回 {messages, tokensFreed, boundaryMessage}。
Snip 的实现涉及一个微妙的工程细节:主循环的 token 计数器从最近的 assistant 消息的 usage 字段推导上下文大小,而该消息在 Snip 后仍然保留,其 input_tokens 值是 Snip 前的值。因此 Snip 释放的 token 数对计数器不可见,必须通过 snipTokensFreed 显式传递给 Autocompact [1]。
Snip 还负责清除"僵尸消息",过时的工具结果、孤立的进度标记、已被新结果取代的文件读取。这些消息不再被后续对话引用,保留它们只会增加噪声。
3.4 Level 3: Microcompact — 缓存感知的双路径设计
Microcompact 是五层管线中设计最精妙的一层。它始终运行基于时间的路径,并在 CACHED_MICROCOMPACT feature flag 启用时运行缓存感知路径。
基于时间的路径清除超过一定时间阈值的旧工具结果。缓存感知路径利用 Anthropic API 的 cache_edits 机制,从已缓存的 prompt 中修剪内容,而不导致缓存失效。这是一个关键的经济优化:Claude Code 的 prompt 缓存文档指出,缓存命中时输入 token 的价格仅为未缓存的 10% 。如果压缩操作导致 prompt 前缀改变,所有已缓存的 token 都需要重新计算(cache miss),成本瞬间提升 10 倍。
论文记录了一个 2026 年 1 月的内部实验数据:不使用缓存感知路径时,"98% 的请求是缓存未命中,成本约为整个 fleet 缓存创建量的 0.76%" 。
当缓存感知路径启用时,boundary messages 被延迟到 API 响应之后发出,以便使用实际的 cache_deleted_input_tokens 而非估计值。Microcompact 返回 {messages, compactionInfo},其中 compactionInfo 可能包含 pendingCacheEdits。
3.5 Level 4: Context Collapse — 非破坏性的虚拟投影
Context Collapse 由 CONTEXT_COLLAPSE feature flag 门控,是五层管线中唯一不修改底层数据的策略。它是一个读时投影(Read-Time Projection):通过 applyCollapsesIfNeeded() 将 messagesForQuery 数组替换为折叠后的视图,模型看到的是压缩版本,而完整历史保留在 REPL 数组中,可用于重建。
源码注释解释了这一设计:"Nothing is yielded; the collapsed view is a read-time projection over the REPL's full history. Summary messages live in the collapse store, not the REPL array. This is what makes collapses persist across turns."
Context Collapse 将连续的确认性消息("好的"、"我明白了")和重复的工具交换模式折叠为紧凑视图。与其他四个策略不同,Context Collapse 在没有用户可见输出的情况下运行,Autocompact 会在 transcript 中产生可见的摘要,Microcompact 会发出 boundary marker,Context Collapse 则完全透明。
3.6 Level 5: Autocompact — 最后的防线
Autocompact 是压缩管线的最后手段,启用时(默认启用,可通过配置禁用),当上下文在 normalizeMessagesForAPI() 期间超过阈值时触发。
执行机制:Autocompact 派生一个子 Agent,使用专用的摘要提示对所有 boundary 之前的消息执行全量摘要。摘要提示指导模型保留任务上下文、关键决策、已修改的文件路径以及所有未关闭的工作线程。
Chain-of-Thought Scratchpad 技术:压缩提示使用两阶段 CoT 技术。formatCompactSummary() 函数剥离 <thinking> 块,仅保留 <summary> 部分。思维链推理显著提升了摘要质量,而推理过程本身如果保留在上下文中则会浪费 token。"丢弃工作过程,保留结论"。
buildPostCompactMessages() 的输出结构[1]:[boundaryMarker, ...summaryMessages, ...messagesToKeep, ...attachments, ...hookResults]
Boundary marker 通过 annotateBoundaryWithPreservedSegment() 标注保留片段的元数据(headUuid, anchorUuid, tailUuid),用于读时链式修补。这种追加式设计意味着压缩从不修改或删除已写入的 transcript 行,只追加新的 boundary 和 summary 事件。
Autocompact 的最大风险是模型"遗忘"刚刚编辑过的文件。系统自动运行 runPostCompactCleanup() 来缓解这一问题[8]。此外,压缩后 attachment builders 会从活跃的应用状态重新宣布运行时状态(plans、skills、async agents),因为压缩会丢弃之前的 attachment messages,而底层状态仍然存在[1]。
Anthropic 官方 API(compact_20260112)将这一机制标准化为服务端压缩:当 token 数超过可配置阈值(最低 50K,默认 150K)时自动触发。用户也可以通过 /compact 命令手动触发,或使用 /rewind 回退到已缓存的早期前缀。
四、学术前沿:Agent 上下文压缩的四种范式
Claude Code 的五层管线是工业实践的代表。学术界在 2025-2026 年围绕同一问题提出了四种互补范式:
4.1 自适应压缩:SelfCompact
SelfCompact(arXiv:2606.23525)提出让模型自身决定何时以及如何压缩。它配对两个推理时元素:(1) 模型可调用的压缩工具,用于摘要已累积的上下文;(2) 轻量级规则(rubric),指定何时触发(子任务已完成、轨迹正在收敛)和何时抑制(推导中途、陷入僵局时)。
关键发现:工具和规则缺一不可。单独提供压缩工具时,开源模型的使用模式极不稳定。有时在无用的时间点调用,有时完全不调用;单独提供规则则无法执行操作。两者结合后,无需任何微调,在 6 个基准(竞赛数学和 Agent 搜索)和 7 个模型上,SelfCompact 以 30-70% 的成本降低匹配或超越了固定间隔摘要,在数学任务上比无摘要基线提升高达 18.1 个百分点。
4.2 优化式压缩:Acon
Agent Context Optimization(Acon,arXiv:2510.00615)采用自然语言空间的迭代优化:通过分析 Agent 的失败案例,迭代精化压缩指南,确保关键状态信息在不微调模型的情况下被保留。为进一步降低计算开销,优化后的压缩器被蒸馏到更小的模型中。
在 AppWorld、OfficeBench 和 Multi-objective QA 上,Acon 将峰值 token 使用量降低 26-54%,同时提升了任务成功率。值得注意的是,Acon 使小模型能够有效地作为长周期 Agent 运行,性能提升高达 46%,通过消除上下文干扰实现。
4.3 神经修剪:SWE-Pruner
SWE-Pruner(arXiv:2601.16746)采用完全不同的方法:它不是压缩对话历史,而是作为中间件拦截文件操作工具返回的原始代码,在代码进入 Agent 上下文之前执行行级修剪[13]。
核心组件是一个 0.6B 参数的神经 skimmer(基于 Qwen3-Reranker 骨干 + CRF 头),模拟人类程序员"选择性浏览"源代码的方式。Agent 提供一个显式的目标提示(如"关注错误处理"),skimmer 据此动态选择相关行。在 SWE-bench Verified 上实现 23-54% 的 token 缩减,在单轮任务 LongCodeQA 上实现高达 14.84× 的压缩率。
4.4 强化学习压缩:ZipRL
ZipRL(arXiv:2605.28069)将上下文压缩建模为强化学习问题。它使用多粒度压缩(从粗到细),通过上下文内提示让 Agent 主动感知检索内容的相关性并动态选择压缩策略。为解决 RL 训练中的稀疏奖励问题,ZipRL 提出 Hindsight Response Replay(HRR),利用面向上下文的启发式指标高效评分压缩片段。在 4B 和 8B 参数模型上分别超越最强基线 27.9% 和 34.7%,在长达 256 轮的长上下文交互中保持高 token 效率。
五、问题的另一面:编码 Agent 的 Harness 限制
上一节讨论的所有方法。无论是 Claude Code 的五层管线还是学术界的四种范式,都是事后压缩:等上下文膨胀后再裁剪。这种方法有一个根本局限:Agent 的代码探索过程本身就是低效的。
5.1 传统探索模式的代价
编码 Agent 探索代码库的标准工作流是:grep 搜索关键词 → Read 读取文件 → 发现新线索 → 再次 grep → 再次 Read。这个循环有三个结构性问题:
- 无结构理解:grep 返回匹配行,不理解代码的语义结构(类层级、调用链、模块边界)。Agent 需要多轮工具调用来建立这些理解。
- 上下文雪球效应:每次 Read 工具返回一个完整文件(或文件的大片段),这些内容全部进入对话历史。即使只需要其中 3 行,整个文件也会占据上下文窗口。
- 探索路径不确定性:Agent 不知道需要的信息在哪里,因此执行大量试探性搜索。SWE-Effi 的数据表明,Agent 在失败任务上的工具调用次数是成功任务的数倍。
- Claw-SWE-Bench 的评估数据提供了量化证据:仅更换 Agent harness(同一模型),Pass@1 的差异可达 12.5-27.4 个百分点。换言之,harness 的探索效率,而非模型能力。在许多情况下是性能的决定因素。
5.2 Codebase-Memory 论文的量化对比
Codebase-Memory(arXiv:2603.27277)是第一篇系统评估结构化代码检索 vs 传统文件探索的学术论文。在 31 个真实仓库上的评估显示:
- 结构化检索达到 83% 的回答质量(vs 文件探索的 92%)
- token 消耗降低 10 倍
- 工具调用减少 2.1 倍
- 在图原生查询(hub 检测、调用者排名)上,19/31 种语言匹配或超越文件探索
这一结果揭示了核心权衡:结构化检索在关系性和结构性导航上显著优于文件探索,代价是在需要穷举模式匹配的场景下回答质量略低。最优方案是两者的混合——结构化检索处理"X 是如何工作的?"类问题,文件探索处理"所有使用 Y 的地方"类问题。
六、Codegraph:结构化检索的工程实现
Codegraph 是一个开源 MCP 服务器,将代码库预索引为本地 SQLite 知识图谱。它的核心设计思路是:将代码探索的成本从运行时(每次 Agent 会话)移到构建时(一次性索引)。
6.1 架构概览
Codegraph 的处理管线分为三个阶段:
阶段一:代码解析(Tree-sitter → AST → 节点提取)
源代码文件
→ Tree-sitter 解析器(per-language WASM grammar)
→ AST 遍历
→ 节点提取(函数、类、方法、变量、常量、接口、枚举…)
→ 边提取(调用、引用、继承、实现、装饰器…)
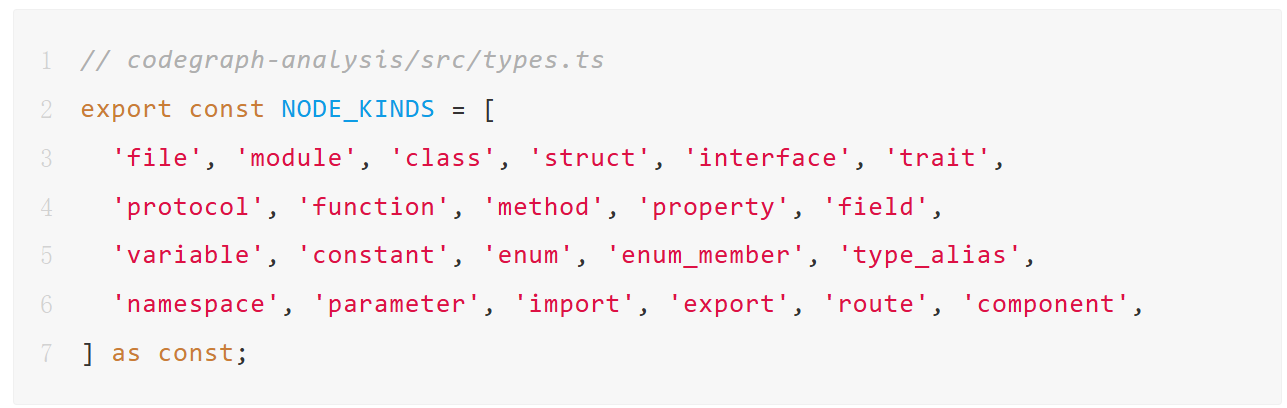
Codegraph 使用 web-tree-sitter 的 WASM 运行时加载语言语法。src/extraction/tree-sitter.ts 中的核心提取函数为每个源文件生成 ExtractionResult,包含 Node[] 和 Edge[]。节点类型(NodeKind)覆盖 21 种代码实体:
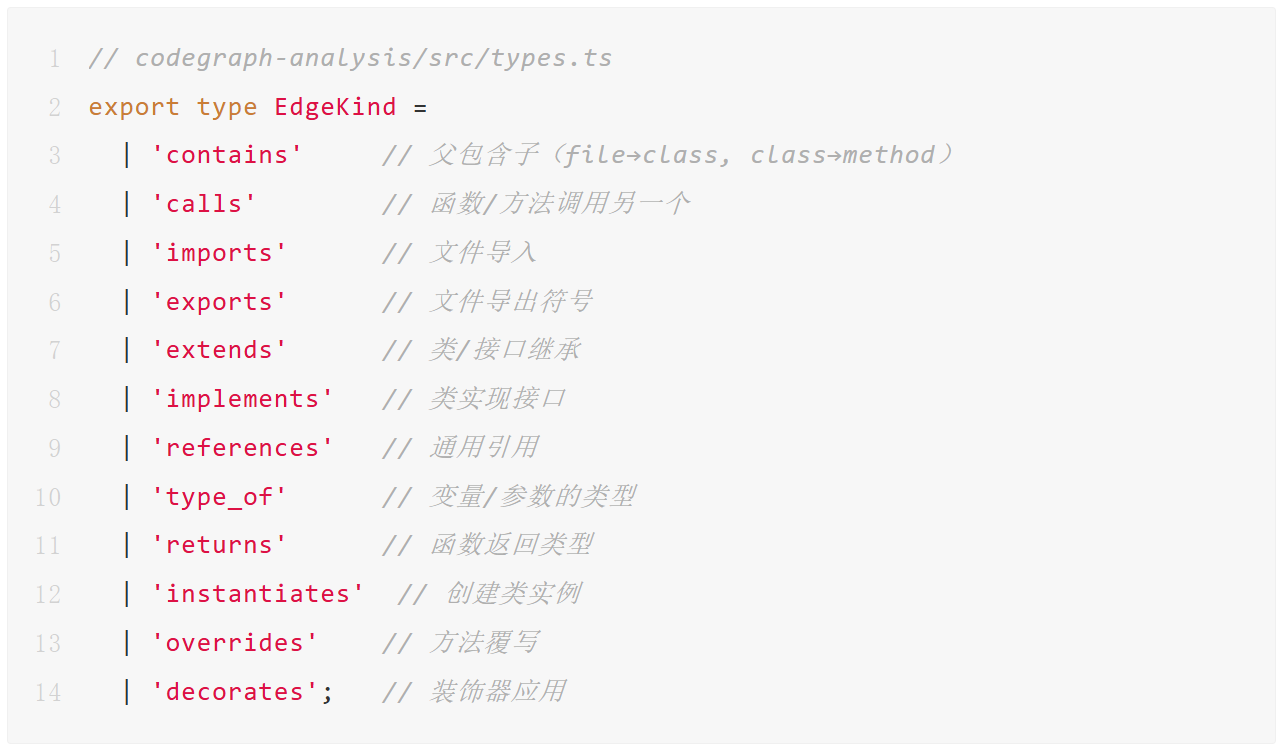
边类型(EdgeKind)覆盖 12 种关系:
阶段二:引用解析(Import Resolution + 框架特化)
原始提取的节点和边包含大量未解析的引用——例如 import { Foo } from './bar' 只产生一个指向路径 ./bar 的未解析引用。src/resolution/ 目录实现了完整的引用解析管线[6]:
- import-resolver.ts:解析模块路径,处理路径别名(tsconfig.json 的 paths)
- path-aliases.ts:处理 TypeScript、Webpack 等工具的路径映射
- name-matcher.ts:符号名匹配和消歧
- frameworks/ 目录:针对 20+ 框架(React、Vue、Svelte、Go、Rust、Python、Java、Swift、Ruby、C#、Laravel、NestJS、Express 等)的特化解析器
框架特化解析是 Codegraph 区别于简单 AST 分析的关键。例如 frameworks/react.ts 理解组件的 props 传递和 hook 调用链;frameworks/go.ts 理解 Go 模块系统和接口隐式实现。
阶段三:持久化与查询(SQLite + FTS5)
所有节点和边被写入 SQLite 数据库,src/db/queries.ts 中的 QueryBuilder 提供结构化查询接口[6]。src/graph/queries.ts 中的 GraphQueryManager 在此之上构建高层查询:
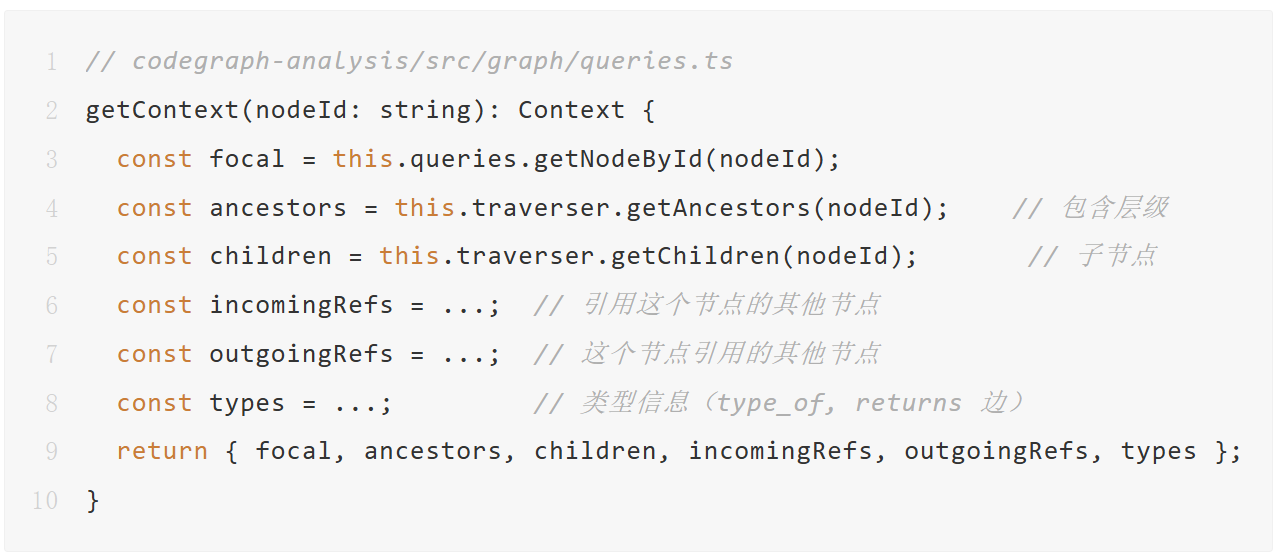
全文搜索使用 SQLite FTS5 扩展,支持前缀搜索、模糊匹配和按相关性排序。
6.2 MCP 工具集
Codegraph 通过 MCP(Model Context Protocol)向编码 Agent 暴露工具[6]。src/mcp/tools.ts 定义了核心工具集:
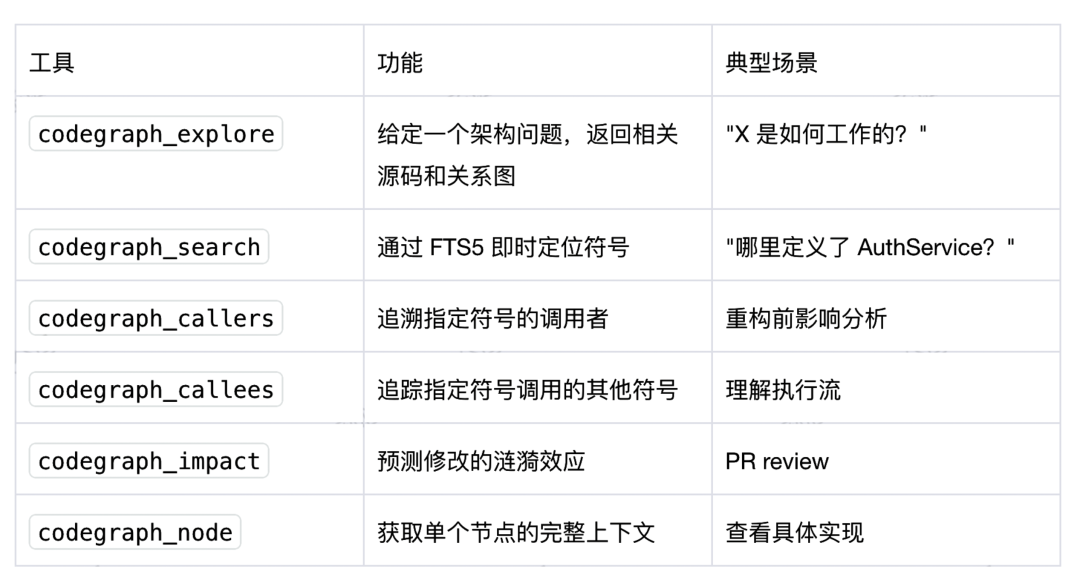
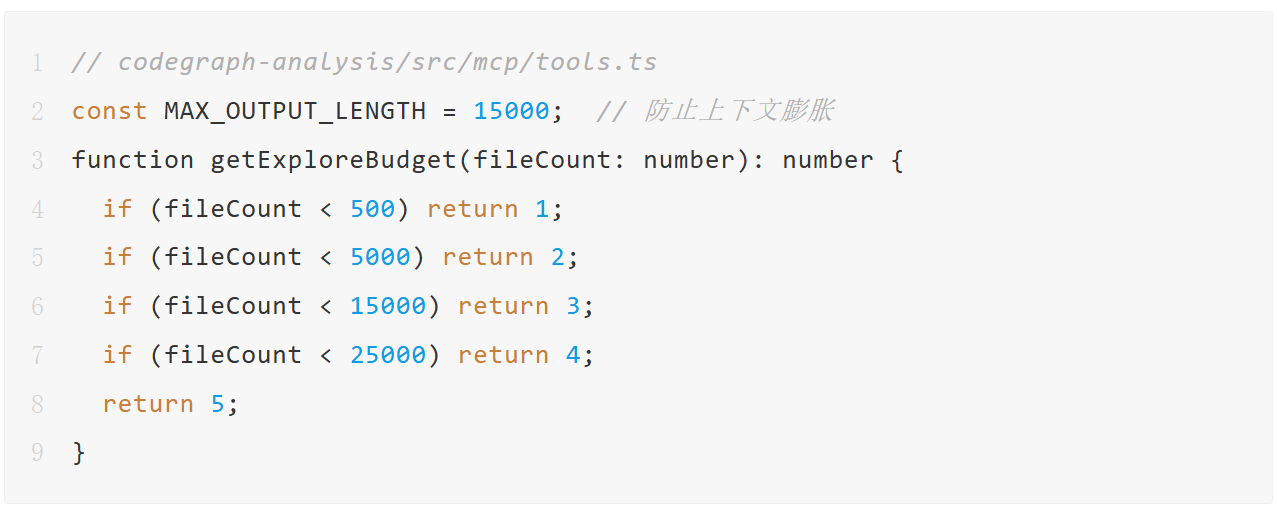
codegraph_explore 是最核心的工具。它的输出经过精心设计以控制上下文大小:
对于容器类型节点(class、struct、interface 等),codegraph_node 返回结构化大纲(成员名 + 签名 + 行号)而非完整体。这避免了一个大类的多千字符源码膨胀 Agent 的上下文。codegraph_explore 还会折叠冗余的可互换实现为签名,使响应大小与答案相关而非文件数量相关。
6.3 实时同步机制
src/sync/watcher.ts 使用操作系统原生文件事件(macOS FSEvents、Linux inotify、Windows ReadDirectoryChangesW)监听文件变更[6]。变更的文件被重新解析和索引,保持知识图谱与代码库的一致性。src/sync/watch-policy.ts 定义了监听策略,排除 node_modules、.git 等目录。
6.4 基准测试数据
Codegraph 在 7 个跨语言开源代码库上进行了基准测试,使用 Claude Code(headless 模式)回答架构问题,每组 4 次运行取中位数:
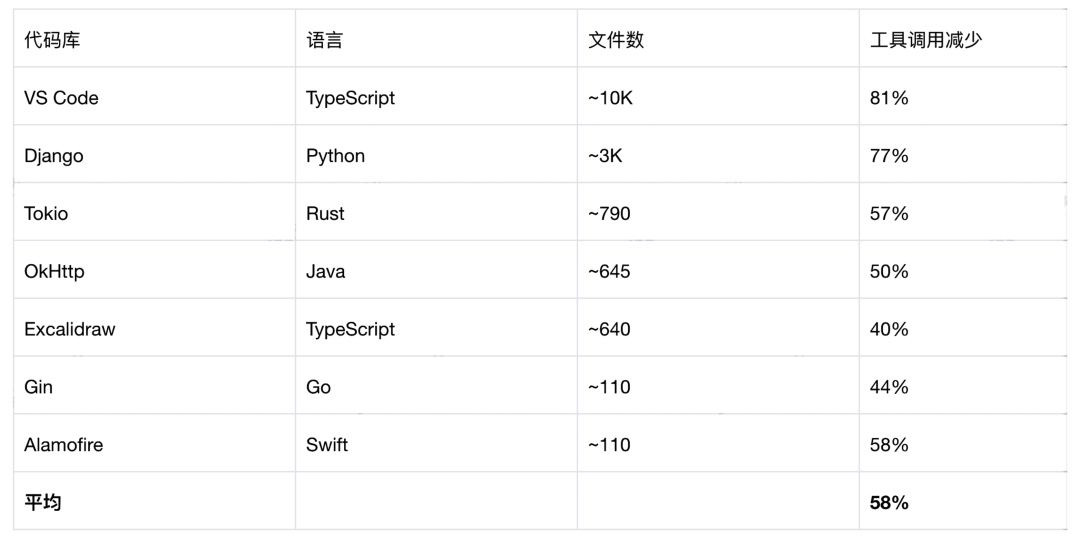
这组数据的关键特征是:
- 工具调用和速度的提升在所有代码库上一致,与规模无关
- File Reads 降至接近零:有 Codegraph 时 Agent 几乎不需要读取文件,无 Codegraph 时平均需要读取 4-9 个文件
- Token 和成本节省与规模相关:小项目的节省更显著(Alamofire: 40%),大项目因为 Codegraph 返回的大型缓存友好响应替代了多次小的 grep/read 往返,成本趋于持平
- 独立验证来自 Tekkix 的技术分析,该分析在更大的代码库上重现了类似结果:VS Code(4002 文件)从 52 次工具调用降至 3 次(94% 减少),Swift 编译器(25,874 文件、272,898 节点)在 4 分钟内完成索引,Agent 以 6 次调用和零文件读取在 35 秒内回答了复杂的跨模块问题。
七、学术视角:代码知识图谱的三种架构
Codegraph 并非孤立的工程实践。学术界在 2025-2026 年提出了三种代码知识图谱架构,各有不同的设计取舍:
7.1 CodexGraph:图数据库 + 查询语言
CodexGraph(NAACL 2025)将代码仓库提取为图数据库,节点为 MODULE、CLASS、FUNCTION 等源码符号,边为 CONTAINS、INHERITS、USES 等关系。Agent 通过图查询语言(而非自然语言)精确检索代码结构。
CodexGraph 的优势在于查询的精确性——图查询语言消除了自然语言的歧义。在 CrossCodeEval、SWE-bench 和 EvoCodeBench 上展示了竞争力的性能。局限是需要图数据库基础设施(如 Neo4j),增加了部署复杂性。
7.2 PROMETHEUS:统一知识图谱 + 多语言
PROMETHEUS 构建统一的代码知识图谱,集成文件结构、AST 和文本内容。三个核心组件:
- FileNode:文件或目录,属性包含唯一 ID、相对路径和基本名
- ASTNode:Tree-sitter 语法节点,包含起止行、代码文本和类型
- 持久化到 Neo4j
- 构建策略有意采用浅层方式——仅关注深度 0(完整源码文件)和深度 1(顶层构建块:import、函数定义、类定义、全局变量)的节点。在 7 种编程语言上实现 25.7%(77/300)的 issue 解决率。
7.3 Codebase-Memory:轻量级 MCP 方案
Codebase-Memory(arXiv:2603.27277)选择了与 Codegraph 最接近的技术栈:
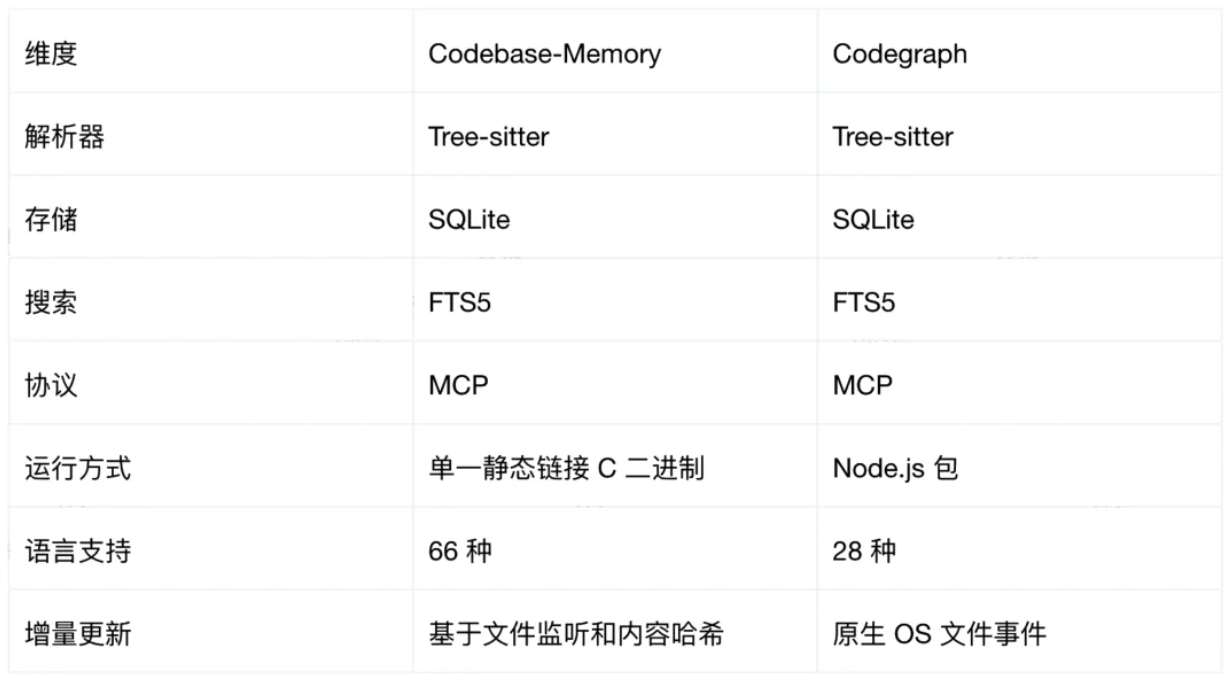
Codebase-Memory 强调零依赖和广泛的语言覆盖。在发布四周内获得 900+ star,被 10 个编码 Agent(包括 Claude Code、Codex CLI、Gemini CLI)自动检测。
八、事后压缩 vs 事前检索:互补而非替代
Claude Code 的压缩管线和 Codegraph 的结构化检索并非竞争关系,而是解决同一问题的两个互补维度:
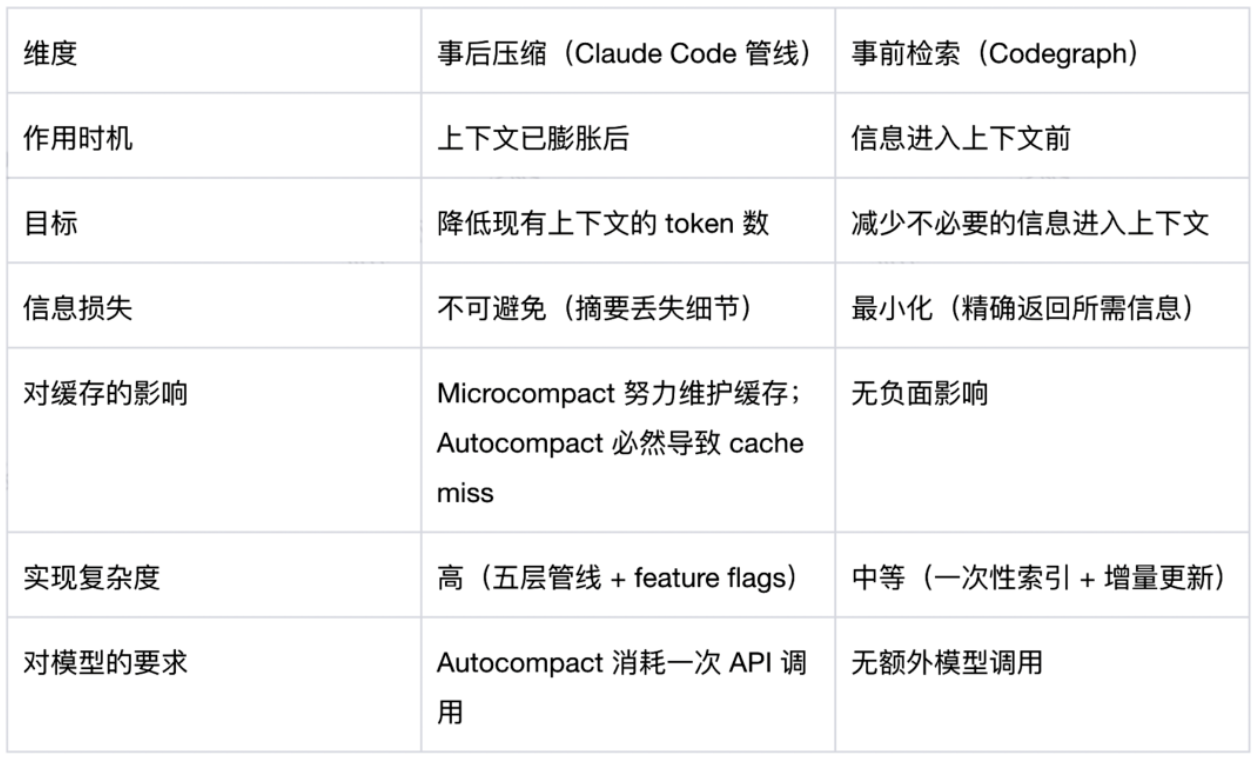
最优的 Agent 系统应该同时使用两者:Codegraph 在信息进入上下文前精确定位。Agent 不再需要执行 20 次 grep + Read 来理解一个模块的架构,一次 codegraph_explore 即可返回完整的符号关系和关键源码。这从源头减少了上下文膨胀。Claude Code 的压缩管线作为安全网,处理即使在精确检索下仍然会累积的对话历史和工具结果。
Claw-SWE-Bench 的研究提供了架构层面的支撑:同一模型下,仅更换 harness 可以带来 12.5-27.4 个百分点的性能差异[16]。这意味着投资于更好的探索工具(如 Codegraph)和更好的上下文管理(如五层压缩管线)的回报,可能超过投资于更强模型的回报。
九、开放问题与未来方向
9.1 压缩时机的自主决策
Claude Code 当前的压缩触发基于 token 阈值,一个静态的、与任务无关的条件。SelfCompact和 Acon的研究表明,让模型(或独立的元认知模块)根据轨迹结构决定压缩时机,可以显著提升性能。未来的 Agent 系统可能需要一个"上下文管理器"角色,专门负责监测上下文质量并在最佳时机触发压缩。
9.2 跨会话的知识持久化
当前的代码知识图谱是会话级的,每次 Agent 启动都需要重新理解代码库(即使 Codegraph 提供了预索引)。Dive into Claude Code 论文识别了这一开放方向:跨会话持久化。如何在会话之间保留 Agent 对代码库的理解,而不仅仅是用户指令(CLAUDE.md)。
9.3 压缩与检索的统一框架
当前的事后压缩和事前检索是独立的子系统。未来可能出现统一框架:知识图谱不仅提供检索,还指导压缩。例如基于符号的重要性(调用频率、修改历史)决定哪些上下文优先保留,哪些优先压缩。
9.4 评估标准的演进
传统的 resolve rate 指标忽略了 Agent 的资源效率。SWE-Effi 的 Effectiveness under Token Budget(EuTB)和 Claw-SWE-Bench 的 Pareto 前沿分析代表了评估标准的演进方向:不仅衡量 Agent 能否完成任务,还衡量它以多少资源完成任务。成本分析数据显示,在企业规模(每月 50,000+ 任务)下,每个任务 $74 vs $0.46 的差异决定了自动化项目是否有正 ROI 。
参考文献
[1] Liu, J., Zhao, X., Shang, X., & Shen, Z. (2026). Dive into Claude Code: The Design Space of Today's and Future AI Agent Systems. arXiv:2604.14228.
[2] AgentMarketCap. (2026). The AI Agent Inference Cost Race 2026: What It Really Costs to Resolve a GitHub Issue. https://agentmarketcap.ai/blog/2026/04/06/ai-agent-inference-cost-race-2026-swe-bench-token-efficiency
[3] SWE-Effi: Re-Evaluating Software AI Agent System Effectiveness Under Resource Constraints. arXiv:2509.09853.
[4] Liu, N. F., Lin, K., Hewitt, J., Paranjape, A., Bevilacqua, M., Petroni, F., & Liang, P. (2024). Lost in the Middle: How Language Models Use Long Contexts. TACL 2024. arXiv:2307.03172.
[5] Anthropic. (2026). Compaction — Claude API Documentation. https://platform.claude.com/docs/en/build-with-claude/compaction
[6] McHenry, C. (2026). CodeGraph: Pre-indexed code knowledge graph for Claude Code, Codex, Gemini, Cursor. https://github.com/colbymchenry/codegraph
[7] 清华大学. Claude Code 技术分析:对话循环 — Agent 的心跳. https://github.com/lintsinghua/claude-code-book
[8] HarrisonSec. (2026). How Claude Code Compresses Context — The 5-Level Pipeline. https://harrisonsec.com/blog/claude-code-context-engineering-compression-pipeline/
[9] Claude Code Context Management. https://mintlify.wiki/sanbuphy/claude-code-source-code/concepts/context-management
[10] Anthropic. (2026). How Claude Code uses prompt caching. https://code.claude.com/docs/en/prompt-caching
[11] Self-Compacting Language Model Agents. (2026). arXiv:2606.23525.
[12] Agent Context Optimization (Acon): Optimizing Context Compression for Long-horizon LLM Agents. (2025). arXiv:2510.00615.
[13] SWE-Pruner: Self-Adaptive Context Pruning for Coding Agents. (2026). arXiv:2601.16746.
[14] ZipRL: Adaptive Multi-Turn Context Compression with Hindsight Response Replay. (2026). arXiv:2605.28069.
[15] Vogel, M. (2026). Codebase-Memory: Tree-Sitter-Based Knowledge Graphs for LLM Code Exploration via MCP. arXiv:2603.27277.
[16] Claw-SWE-Bench: A Benchmark for Evaluating OpenClaw-style Agent Harnesses on Coding Tasks. (2026). arXiv:2606.12344.
[17] Tekkix. (2026). CodeGraph: A code graph for Claude Code to replace file-wide grep — Architecture breakdown and benchmark verification. https://tekkix.com/articles/ai/2026/05/codegraph-a-code-graph-for-claude-code-to-rep
[18] Liu, B. et al. (2025). CodexGraph: Bridging Large Language Models and Code Repositories via Code Graph Databases. NAACL 2025. ACL Anthology 2025.naacl-long.7.
[19] PROMETHEUS: Unified Knowledge Graph for Multi-Language Issue Resolution. OpenReview.
[20] Anthropic. (2026). Context engineering: memory, compaction, and tool clearing — Claude Cookbook. https://platform.claude.com/cookbook/tool-use-context-engineering-context-engineering-tools
[21] EET: Experience-Driven Early Termination for Cost-Efficient Software Engineering Agents. (2026). arXiv:2601.05777.
[22] Bai, L. et al. (2026). Agent Token Consumption Analysis. https://github.com/LongjuBai/agent_token_consumption_analysis