网心技术 | 主权 AI :每个平台都需要自己的模型,每个模型都需要自己的 Agent
开源模型拐点:从"够用"到"首选"
2026 年,AI 行业发生了一个意义深远的结构性变化:开源模型正在成为开发者和企业的首选,而非备选方案。
Y Combinator 最近在 Lightcone Podcast 中对话了 Ollama 的联合创始人兼 CEO Jeffrey Morgan。Ollama 目前已被 900 万开发者 和 85% 的财富 500 强企业 使用,这让 Morgan 拥有了一个独特的视角,他能看到人们实际在使用哪些 AI 模型,以及这种使用方式正在如何变化。
Morgan 观察到的最大趋势就是:企业和开发者正在大规模转向开源模型。 在 Ollama Cloud 上,这种转变驱动了年初至今 150 倍 的 Token 使用量增长。他甚至预测,未来 80%~90% 的企业 Token 消耗都将来自开源模型。
@ollama is used by 9 million developers and 85% of the Fortune 500... Right now, the biggest shift he sees is toward open models, driven by coding agents, falling costs, and capabilities that are rapidly catching up to the frontier labs.
— Y Combinator (@ycombinator)
这不是一个偶然现象。驱动这场迁移的核心力量可以归结为三个方面:
1. 能力过关:开源模型已经"够用",甚至"好用"
两年前,开源模型和闭源模型之间还有一道明显的能力鸿沟。Llama 2 和 GPT-4 之间的差距是肉眼可见的。到了 2026 年,这道鸿沟已经被大幅缩小,在许多实际业务场景中甚至已经消失。
以 Qwen3.8、DeepSeek V4、Kimi K3、GLM 5.3 为代表的新一代开源模型,在代码生成、逻辑推理、长上下文处理等核心能力上,已经能够匹敌甚至在某些维度上超越主流闭源模型。
更重要的是,对于绝大多数业务场景来说,模型能力的"及格线"早已越过。你不需要一个能写博士论文的模型来做客服对话分析,你需要的是一个能稳定、准确、高效完成特定任务的模型。
在 YC 的那期播客中,有一个有趣的讨论:我们是否还需要一个"上帝模型"(God Model)? 答案越来越倾向于"不需要",至少对于大多数应用场景来说如此。一个通用能力强大的开源基座模型,经过垂直领域的微调和后训练,往往能交出比通用闭源模型更好的答卷。
这就像十年前的数据库选型。你不需要每个项目都用 Oracle,PostgreSQL 加上正确的索引和调优,在绝大多数场景下表现得更好、更可控、更经济。
2. 成本更低:数量级的差距
成本是推动这场迁移的最直接动力。
开源模型的推理成本远低于闭源模型,这不仅仅是"便宜一点"的程度,而是数量级的差距。当你的业务需要处理大规模的 Agent 任务、长链条的推理流程时,Token 消耗量是惊人的。一个典型的 Coding Agent 任务可能消耗数十万乃至数百万个 Token。如果每个 Token 都要按闭源模型的价格付费,这将成为一笔无法承受的开支。
Harvey 的案例完美地说明了这一点。作为全球领先的法律 AI 公司,Harvey 在基于 Kimi K3 进行后训练时,不仅获得了 82% 的性能提升,还实现了不到闭源前沿模型四分之一的运行成本。他们在 Review Table 任务中的后训练模型,成本仅为最强基线模型的十分之一:
Tenet is also optimized for token efficiency, operating at less than a fourth the cost of leading foundation models.
— Harvey (@harvey)
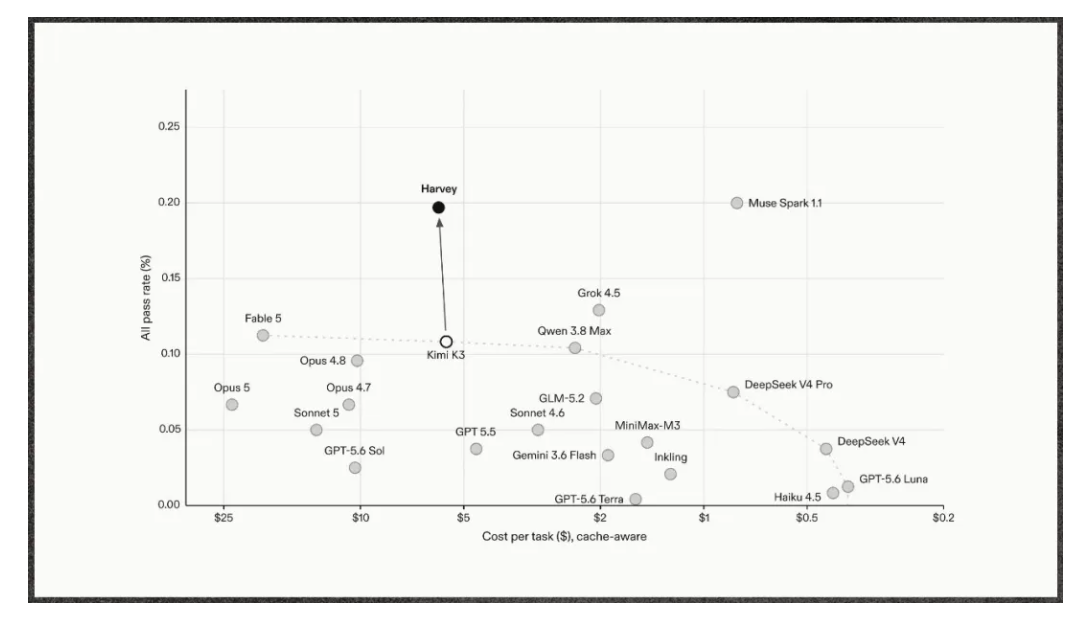
更值得注意的是,Harvey 在后训练过程中同时优化了成本和质量。他们通过 reward shaping 激励高效的工具使用和推理路径,偏好那些在保持同等性能的情况下能减少推理 Token 消耗的轨迹。这意味着后训练开源模型提供了两个降低成本的杠杆:
(1)更低的单价:开源模型的每 Token 价格本身就更低
(2)更少的 Token:通过训练可以让模型学会更高效地推理和使用工具
当 Coding Agent 时代到来,Token 使用量开始呈指数级增长时,成本优势不再是锦上添花,而是生存必需。正如 Ollama 的数据所显示的,Agent 驱动的 Token 使用量增长了 150 倍。如果这些 Token 全部走闭源模型的定价,没有几家公司能承受得起。
3. 数据与业务安全:思考过程即业务核心
这是最深层、也最容易被忽视的原因。
当我们谈论 AI 应用时,数据安全通常被理解为"不要把客户数据泄露给第三方"。这当然重要,在 Agent 时代,安全的含义已经发生了根本性的变化。
在 Agent 架构中,整个业务逻辑和数据的调用链路基本都在模型层的控制之内。 模型不再只是一个"接收输入、返回输出"的黑盒,它是业务流程的编排者、数据的消费者和生产者、工具的调用者。在一个复杂的 Agent 工作流中,模型会:
- 读取和分析业务文档
- 搜索内部知识库
- 调用外部 API
- 生成中间分析报告
- 做出决策并执行操作
这意味着思考过程本身就是业务的核心资产。 模型如何理解你的业务数据、如何组织推理链条、如何选择工具和策略,这些思考轨迹(thinking trajectories)包含了比原始数据更有价值的信息。
如果你的业务生态和数据链条全都依赖闭源模型厂商,你面临的风险不仅仅是"数据泄露",而是业务模式被模型厂商看透并复制。想象一下:
- 你的法律 AI 产品每天通过闭源模型 API 处理数百万份合同
- 模型厂商可以看到你的 Agent 如何分析合同条款、如何识别风险
- 你的 Prompt、工具调用策略、业务逻辑都在 API 调用中暴露无遗
- 有一天,模型厂商推出了自己的法律 AI 产品
这不是阴谋论,这是商业竞争的基本逻辑。当你的整个业务思考过程都运行在别人的模型上时,你本质上是在将自己的护城河拱手让人。
红杉资本的合伙人 Sonya Huang 在最近的演讲 "How Companies Are Building Their Own Intelligence" 中,用一句话概括了这个趋势:
每一个 AI 应用公司,都应该拥有自己的主权 AI 模型(Sovereign AI Model)。
"主权"这个词非常精准。就像一个国家需要在关键技术上拥有自主可控的能力一样,一个 AI 应用公司需要在模型层面拥有自己的"主权"。这意味着:
- 数据主权:训练数据、推理数据、业务数据都在自己的控制之下
- 模型主权:核心模型是自己训练的,可以根据业务需求自由迭代
- 推理主权:推理过程在自己的基础设施上运行,不受第三方限制
- 思考主权:模型的思考过程和策略是自己的知识产权
字节的搜索引擎与 Meta 的自建索引:数据主权的攻防战
主权 AI 的理念不仅限于模型层面。在数据层面,科技巨头们也在打一场静悄悄的主权争夺战。
独立开发者 @levelsio 近期透露了一个值得关注的消息:
Meta is ALLEGEDLY building their own Google search engine, so that if their AI does a web search it doesn't end up at Google, as Google could then use it for THEIR training, so they want their own web index that they will then use as their own Meta search engine for their AI.
— levelsio (@levelsio)
Meta 正在建设自己的搜索引擎,原因并不是要和 Google 在搜索市场上竞争,而是出于防御性考量:如果 Meta 的 AI 在做网页搜索时都走 Google 的接口,那么 Google 就可以通过这些搜索请求来了解 Meta AI 的使用模式、训练数据需求和业务方向,甚至可以利用这些数据来训练自己的竞品模型。
这和主权 AI 模型的逻辑是一脉相承的:防止对手通过你的数据流转来训练自己的模型、抄走你的业务。
字节跳动也在做类似的事情。作为全球最大的内容平台之一,字节的自建搜索引擎不仅仅是一个产品功能,更是其 AI 战略的防御工事。当你的 AI Agent 需要搜索网络来完成任务时,每一次搜索请求都是一次数据泄露。搜索引擎可以看到你的用户在搜什么、你的 AI 在思考什么、你的业务关注点在哪里。
在 Agent 时代,搜索不再是一个简单的"输入关键词、返回结果"的过程。Agent 会进行复杂的、多轮的、上下文感知的搜索,每一轮搜索都蕴含着丰富的业务语义。如果这些搜索全部走第三方引擎,那么第三方引擎事实上就获得了你的 Agent 的"思考日志"。
这形成了一个有趣的安全递归:
→ 使用你的主权模型进行推理(✓ 思考安全)
→ 搜索走 Google 的 API(✗ 搜索行为暴露)
→ 所以你需要自建搜索引擎(✓ 搜索安全)
→ 搜索引擎的爬虫在抓别人的数据(新的博弈...)
主权 AI 不是一个静态的概念,而是一个不断延伸的防御纵深。从模型到数据到基础设施,每一层都需要自主可控。
Harvey 的 Tenet:主权 AI 的教科书级案例
如果要找一个"主权 AI 模型"的教科书级实践,Harvey 发布的 Tenet 模型毫无疑问是 2026 年最具说服力的案例。
Harvey 是全球领先的法律 AI 公司,它们在 2026 年 8 月发布了 Tenet,一个基于开源模型 Kimi K3 进行后训练的法律领域专属模型。这不是一个简单的"微调",而是一套完整的主权模型训练体系。帮助 Harvey 完成这次后训练的合作方 Fireworks AI,也在几乎同一时间宣布了其 Training API 和 Fireworks Lab 的正式发布(GA):
The most ambitious companies are training models to outperform the frontier on the capabilities that differentiate their business. Today, we announce the general availability of our Training API and Fireworks Lab, making model specialization accessible to all organizations.
— Fireworks (@FireworksAI_HQ)
这句话本身就是对主权 AI 趋势最好的注脚:最有野心的公司正在训练自己的模型,以便在定义其业务差异化的能力上超越前沿通用模型。 Fireworks 的平台化,正在让这种"模型专业化"从少数巨头的专利变成所有组织都能触达的能力。
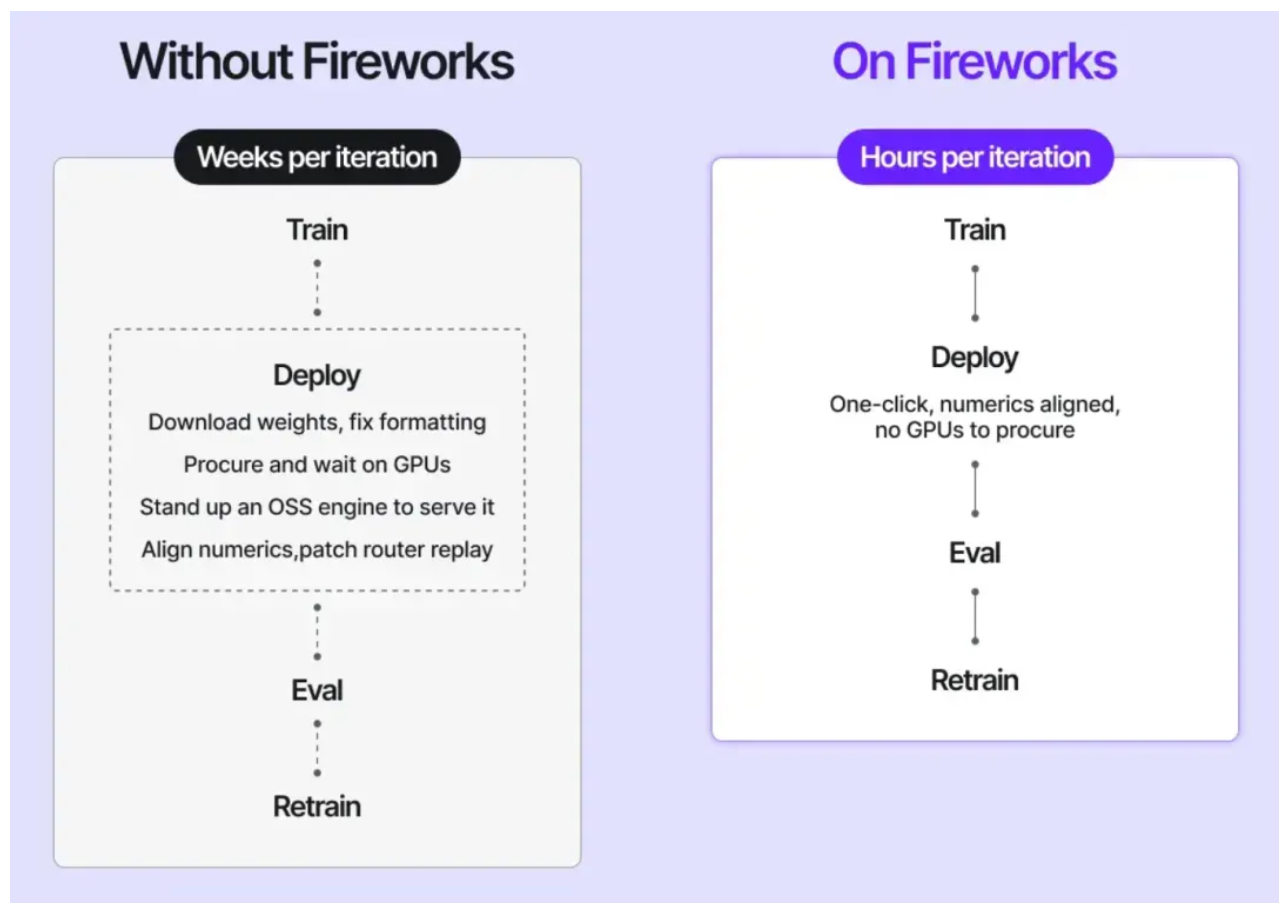
1. 架构:通用基座+垂直后训练+专家子模型
Tenet 的架构设计精确地反映了主权 AI 的核心理念,不是从头训练一个纯垂直模型,而是在通用能力极强的基座模型上进行垂直领域的强化:
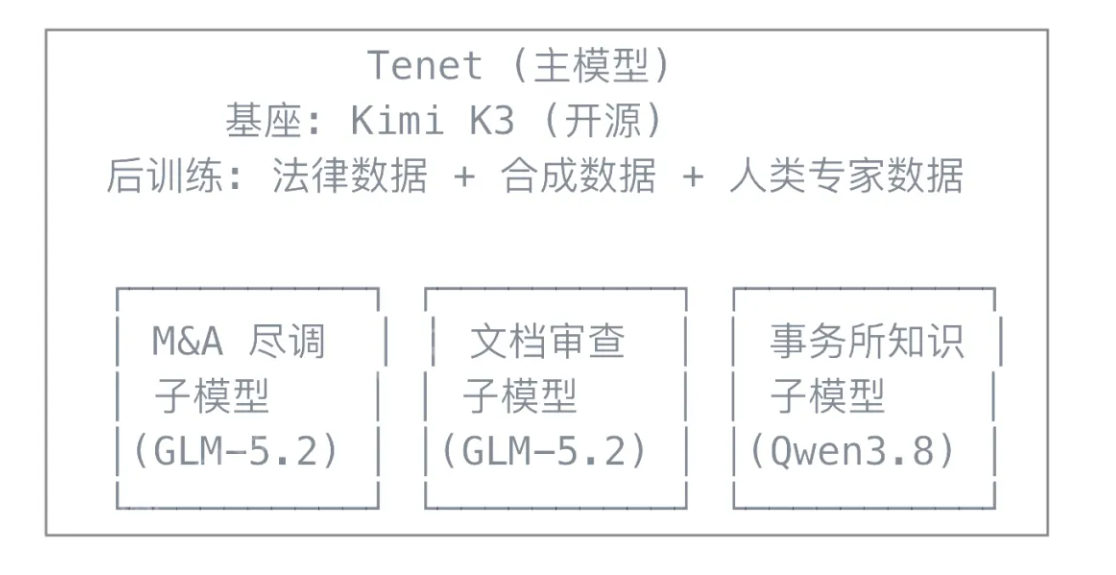
三个专家子模型各司其职:
- M&A 尽调子模型:与 Baseten 合作,在 RLM(递归语言模型)harness 中进行后训练,优化大规模、长链条的尽职调查任务。单个任务需要遍历高达 8000 万 Token 的文档上下文来识别风险并生成尽调备忘录。
- 文档审查子模型:与 Applied Compute 合作,针对大规模文档审查和结构化数据提取进行优化。答案质量提升 3.6 分,引用质量提升 12.1 分,成本仅为最强基线的十分之一。
- 事务所知识子模型:与 Engram 合作,基于 Qwen3.8-27B 训练,将律所的知识编码到参数化记忆和结构化文本笔记中。成本降低 90%,同时智能效率(每 10 万推理 Token 的得分)提升了 3 倍。
2. 训练方法论:在真实环境中强化学习
Harvey 的训练方法论是其主权模型的核心竞争力。他们采用了一套完整的强化学习方案:
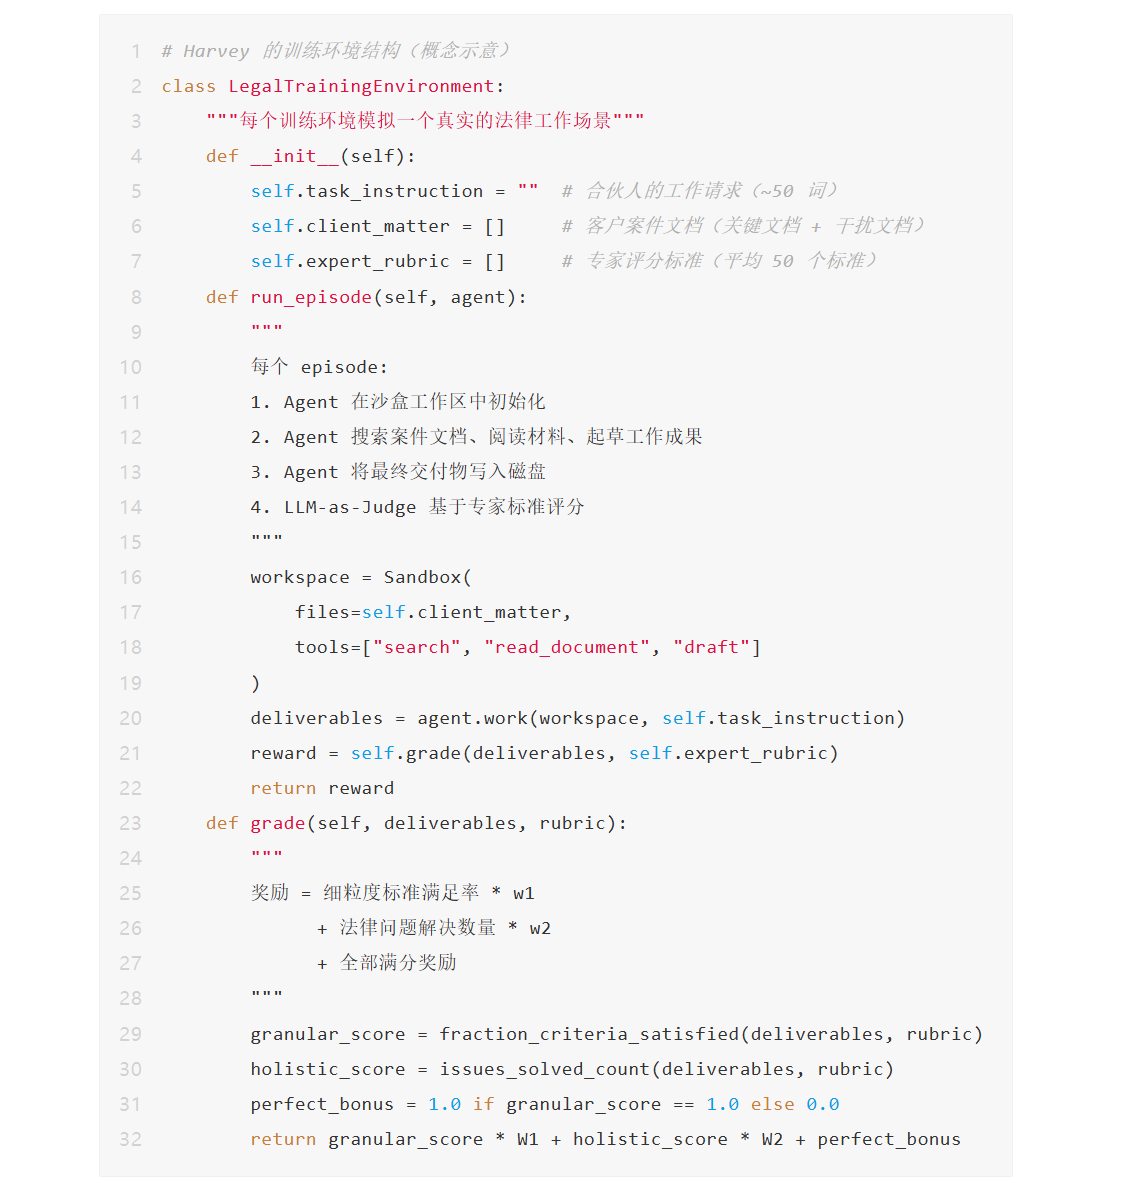
训练使用了 GSPO(Group-Sequence Policy Optimization),对每个任务采样一组独立的 rollouts,在组内计算优势函数并按组方差归一化。关键的技术细节包括:
- Rank-6 LoRA 适配完整 K3 网络(约 50 万专家张量)
- 异步训练-推理循环:Agent rollouts 和训练器异步运行,新权重实时热加载
- 双边裁剪 + 高重要性比 Token 掩码:防止 RL 训练崩溃
- 使用约 150 块 NVIDIA B300 GPU 训练约 2 个月
3. 结果:主权模型比通用闭源模型更好
Harvey 的 Tenet 在多个法律基准测试中取得了令人印象深刻的成绩:
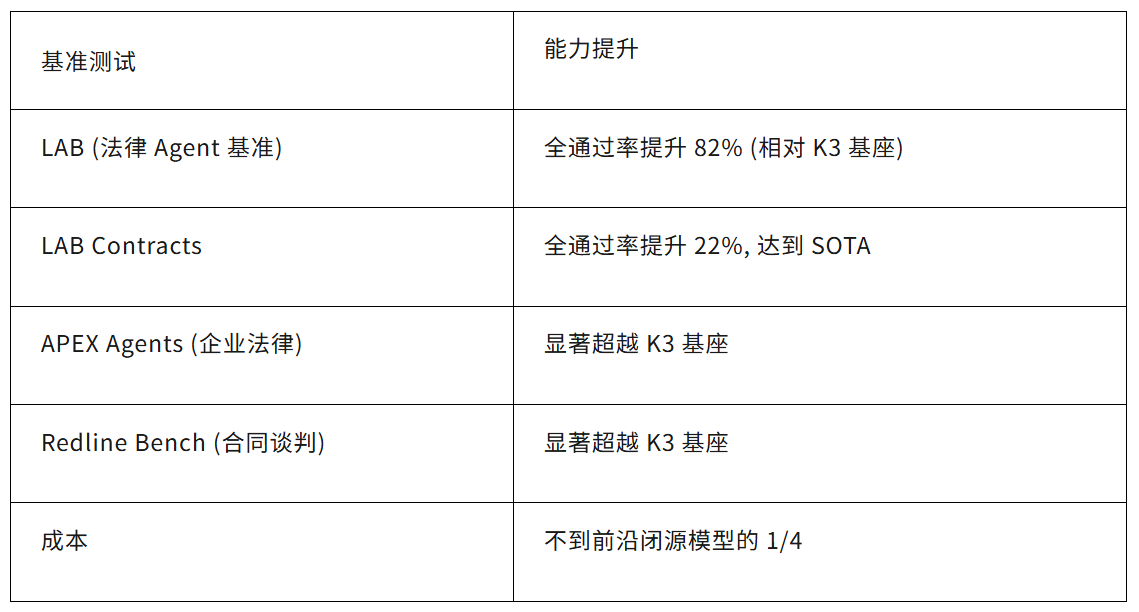
更重要的是,这些改进泛化到了训练时未见过的基准测试上,证明模型学到的不是特定任务的技巧,而是通用的法律推理能力。
Harvey 的案例告诉我们一个关键的架构原则:
主权 AI 模型不是纯垂直模型。它是一个通用能力极强的开源基座模型,在垂直领域通过后训练进行强化,然后结合垂直化的 Agent Harness,构成完整的业务解决方案。
这里"通用能力极强"是关键。Harvey 没有从头训练一个"只懂法律"的模型,而是选择了 Kimi K3 这样的强大通用基座,保留了它在代码能力、逻辑推理、长上下文处理等方面的优势,只在法律领域进行了针对性的强化。最终的模型既能像资深律师一样分析复杂合同,也能像高级工程师一样编写搜索和分析代码。
Agent Harness:垂直化的"操作系统"
如果说主权 AI 模型是"大脑",那么 Agent Harness 就是"身体",它定义了模型如何与外部世界交互、如何使用工具、如何组织工作流程。
Harvey 的成功不仅仅在于训练了一个好模型,更在于他们构建了一套完整的垂直 Agent Harness,包括法律文档搜索工具、合同分析工具、尽调工作流、多 Agent 协同框架等。他们的训练是在这个 Harness 内部进行的,这意味着模型学会的不仅是法律知识,还有如何高效地使用这套工具体系。
这引出了一个更大的趋势:Agent Harness 本身正在成为一个平台层。
1. OpenAI Codex:开源 Agent Harness
在Deepseek 的开源Harness之后,OpenAI 做了一个意义重大的决策:将 Codex 的 Agent Harness 开源。
这不是简单地开源一个代码编辑器插件,而是开源了整个 Agent 的运行环境,包括沙盒、工具调用协议、文件系统访问、终端交互等。OpenAI 在其开发者博客 Codex as a platform: build on the open agent harness 中阐述了这一决策的理由:
Codex 不仅仅是一个编码助手,它是一个可以构建各种 Agent 应用的平台。
开源 Harness 带来的直接效果是:大量开发者和公司开始基于 Codex 的 Agent Harness 构建自己的垂直应用。社区已经涌现出了许多有趣的实践:
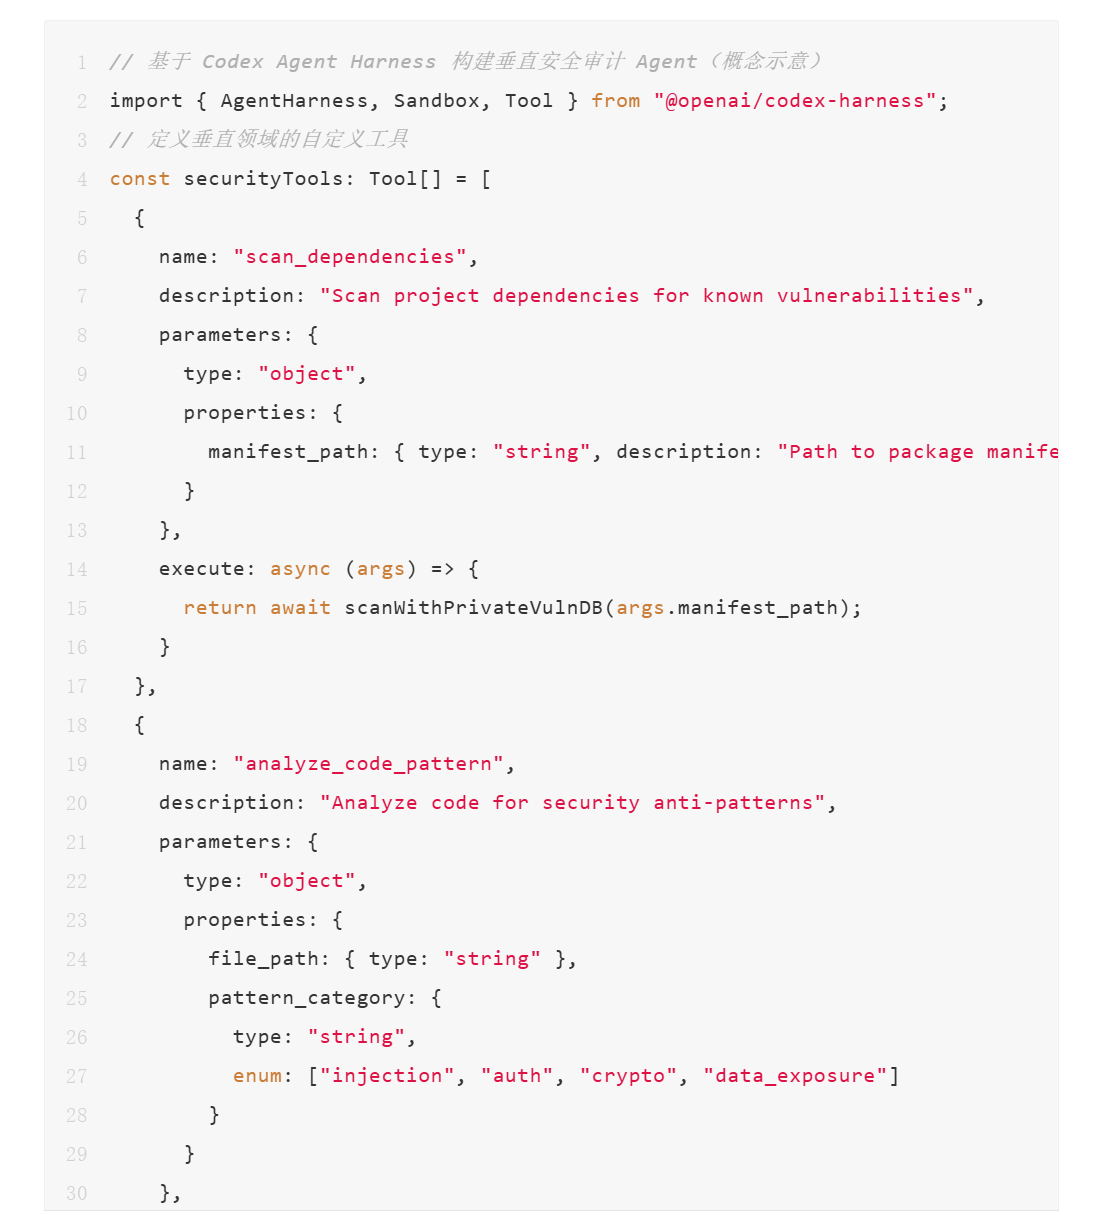
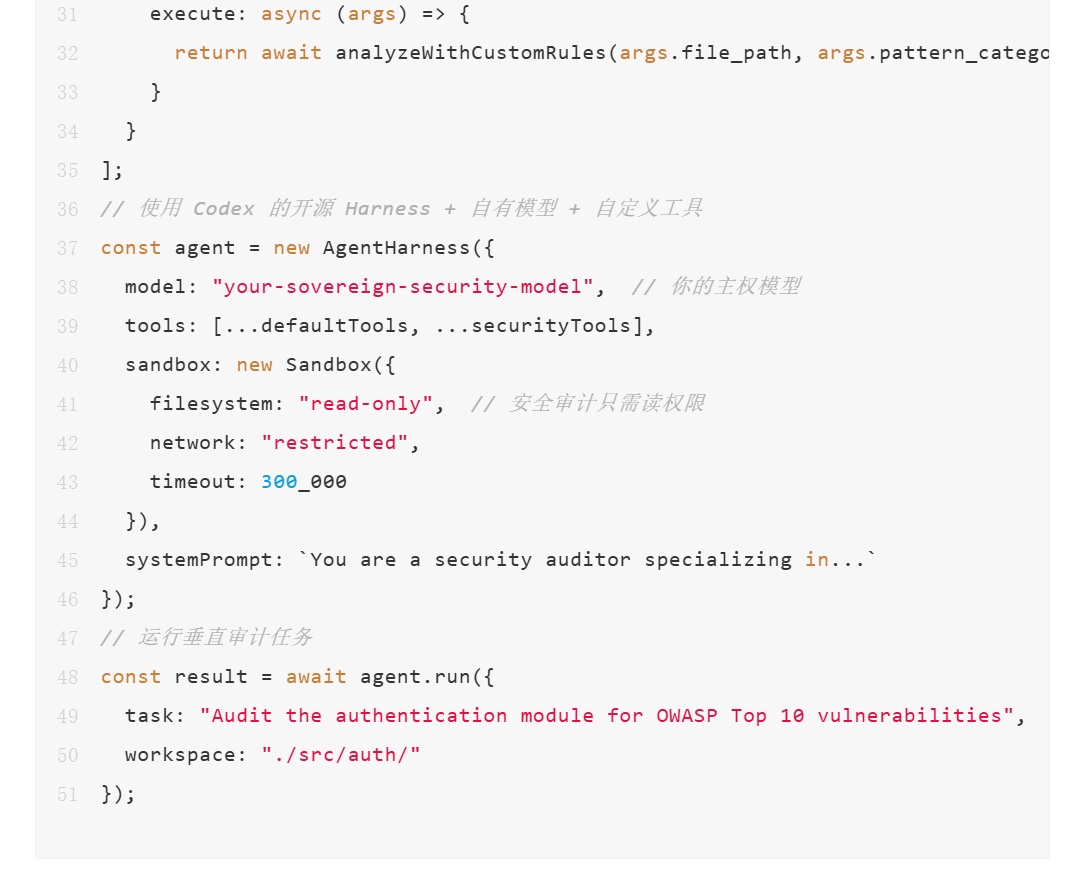
- 安全审计 Agent:基于 Codex Harness 的代码安全扫描和漏洞修复
- 测试生成 Agent:自动分析代码变更并生成对应的测试用例
- 文档同步 Agent:监控代码变更并自动更新相关文档
- 代码迁移 Agent:在框架升级时自动迁移旧代码
这些垂直应用的共同特点是:它们不需要从头构建 Agent 运行时,而是站在 Codex 开源 Harness 的肩膀上,专注于自己的垂直场景。
一个典型的基于 Codex Harness 的垂直 Agent 结构如下:
2. Claude Code Function Hooks:将 Agent 打造成可编程平台
OpenAI 的 Codex 开源 Harness 是"给你一个框架,你去搭建自己的 Agent"。Anthropic 的 Claude Code Function Hooks 走了另一条路:让你在已有的 Agent 中注入自己的业务逻辑。
2026 年 9 月,Anthropic 工程师 Alice Poteat 在 GitHub 上提交了一个 Function Hooks 提案,开篇就说了一句决定一切的话:
"the response from the community likely dictates whether this ships or not."
这个提案的核心思想是:将 Claude Code 的引擎行为暴露为可编程的中间件接口,开发者可以像写 Express 中间件一样,在 Agent 的每一个动作(工具调用、Prompt 提交、会话管理等)前后插入自己的逻辑。
更有趣的是,尽管这个功能"官方尚未发布",其运行时已经内嵌在 Claude Code 2.1.260 版本的二进制文件中,通过一个环境变量即可启用:CLAUDE_CODE_ENABLE_FUNCTION_HOOKS=1 claude
Function Hooks 的核心模型异常优雅。一个 Hook 模块就是一个 TypeScript 文件,导出一个 register 函数:
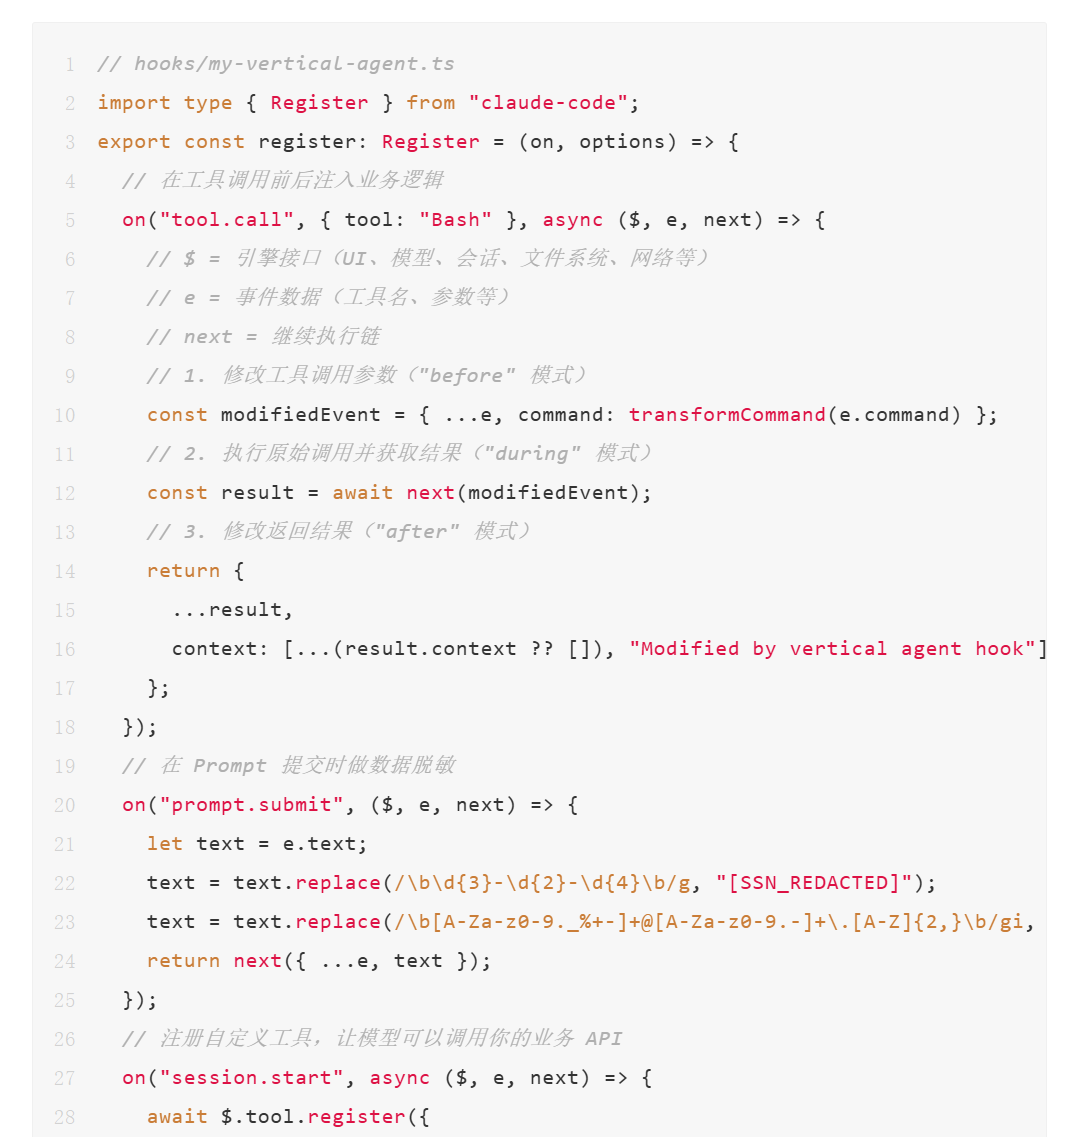
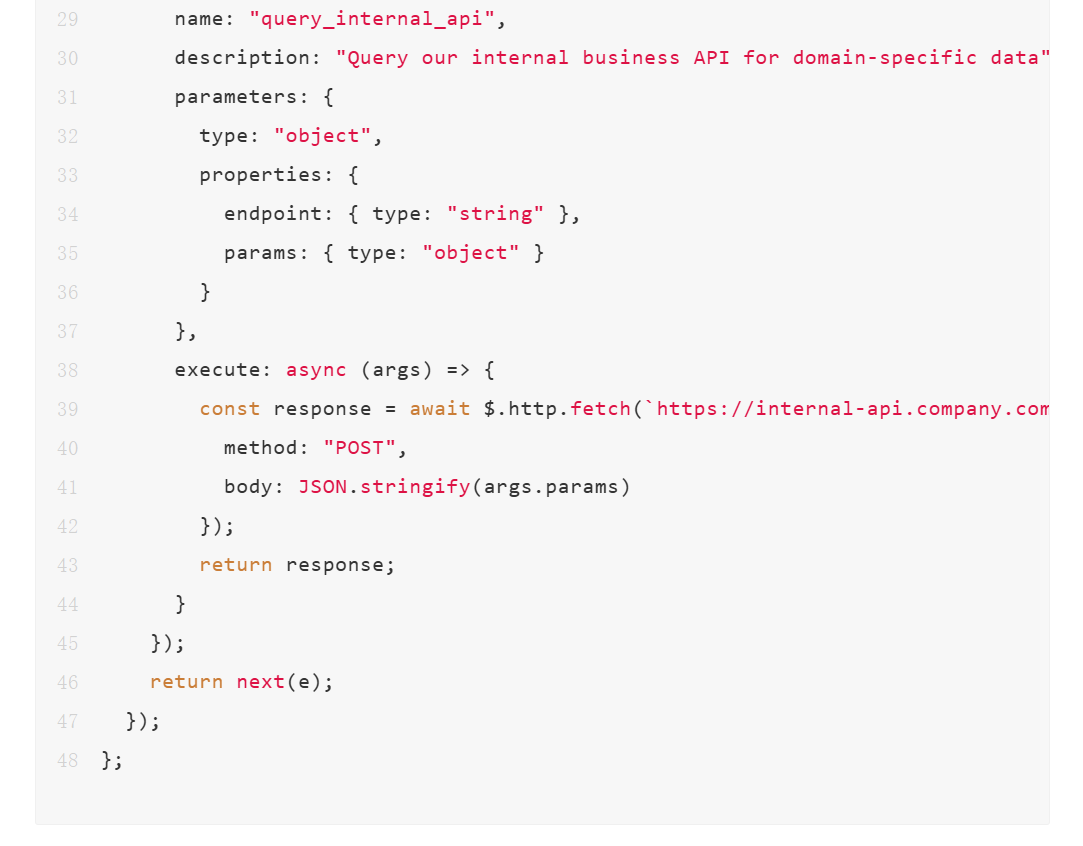
三个参数承载了整个编程模型:
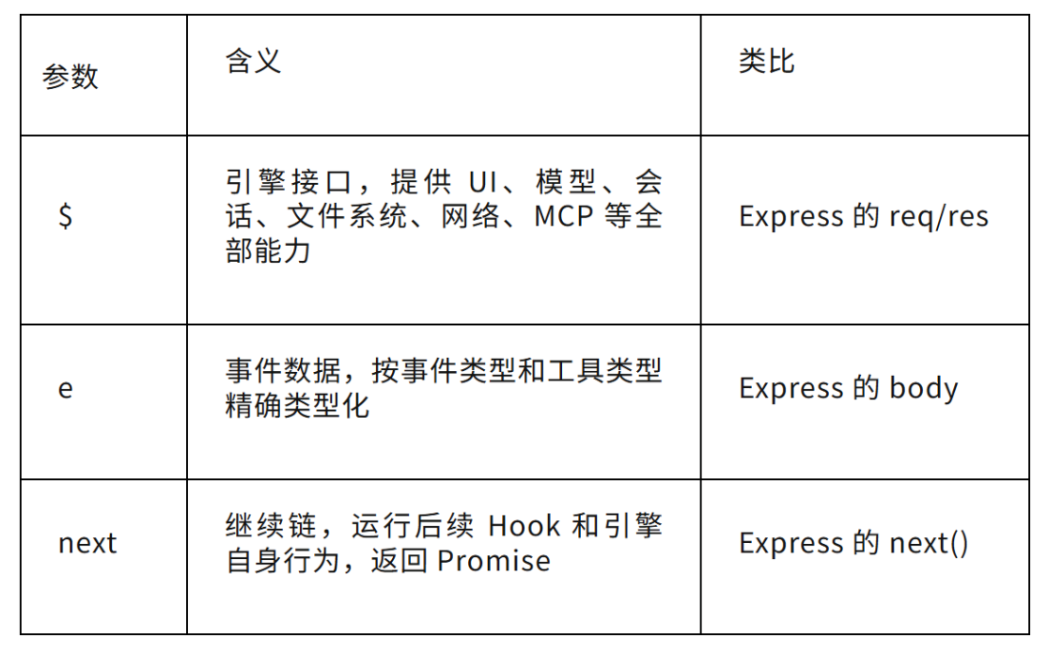
不调用 next 就是替换引擎行为;调用 next(modifiedEvent) 就是改写输入;await next(e) 然后修改返回值就是改写输出。Shell Hook 需要 PreToolUse 和 PostToolUse 两个事件才能完成的操作,Function Hook 在一个注册中就能全部实现。
$接口上的 15 个命名空间提供了丰富的能力:
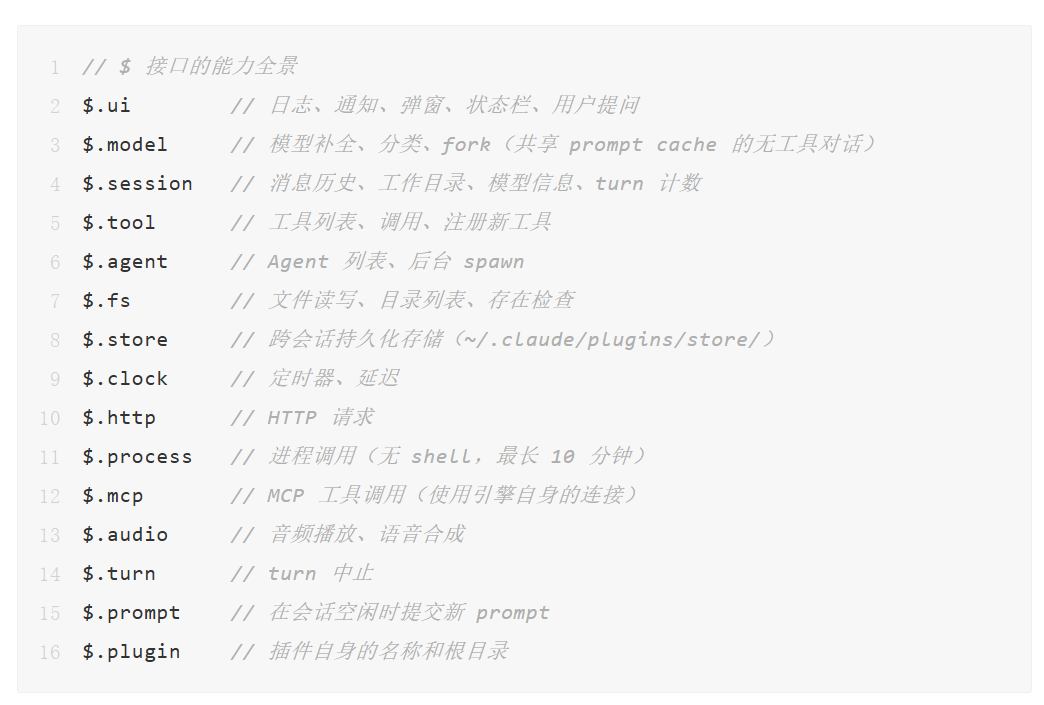
这意味着开发者可以基于 Claude Code 构建自己的垂直 Agent,而不需要从头搭建 Agent 运行时。你只需要:
- 注册你的垂直领域工具(通过 $.tool.register)
- 注入你的业务逻辑(通过事件 Hook)
- 连接你的私有数据源(通过 $.http.fetch 和 $.mcp.call)
- 控制安全边界(通过 tool.call Hook 进行过滤和审计)
主权 AI 的完整架构:基座 + 后训练 + Agent Harness
将上述所有线索串联起来,一个清晰的架构范式正在浮现:
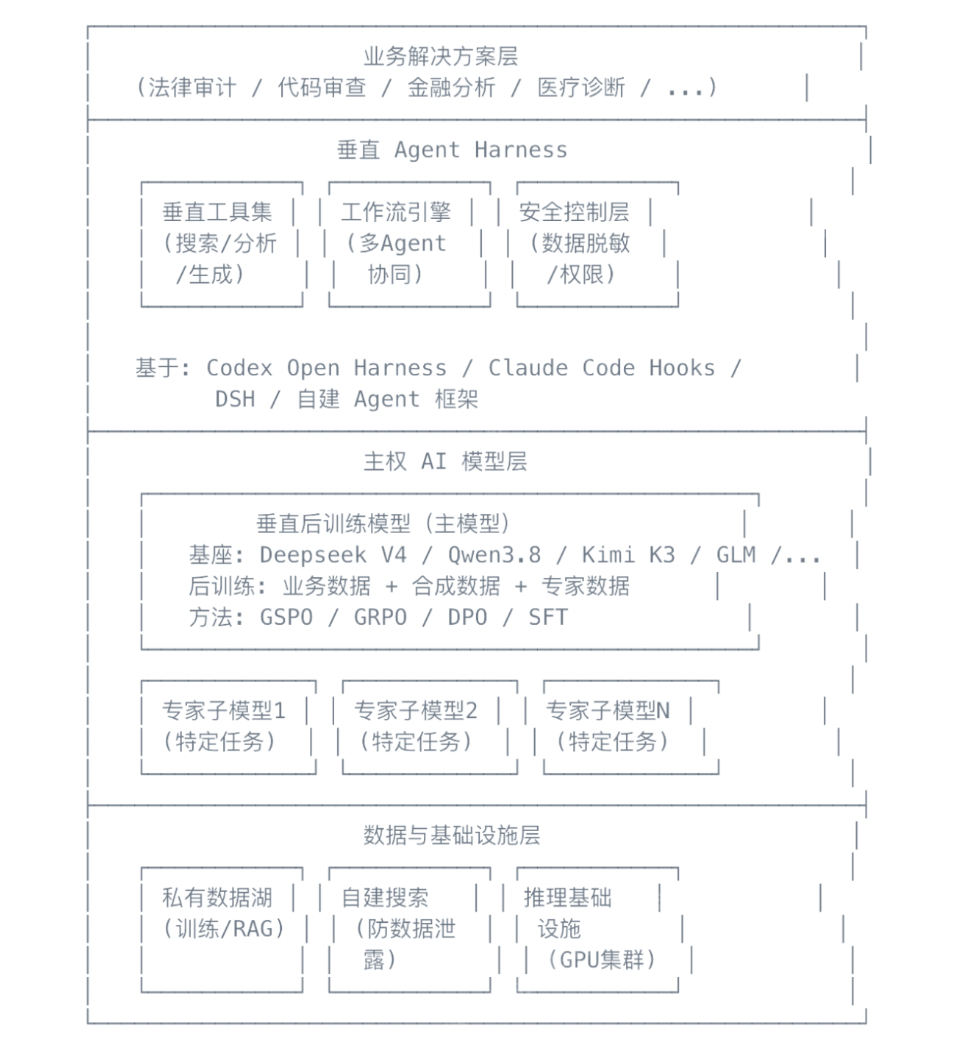
这个架构的每一层都体现了"主权"的理念:
- 数据层:训练数据、业务数据、搜索数据都在自己的控制之下
- 模型层:基于开源基座进行后训练,拥有自己的模型权重
- Harness 层:基于开源平台 Codex/Claude Code 或自建框架,定义自己的工具和工作流
- 应用层:面向特定业务场景的端到端解决方案
1. 为什么不是纯垂直模型?
有人可能会问:既然要做垂直领域,为什么不从头训练一个只懂该领域的模型?
答案是:通用能力是垂直能力的基础。
Harvey 的法律 AI 之所以强大,不仅仅是因为它"懂法律",更因为它:
- 懂代码:能够编写 Python 脚本来搜索和分析大规模文档集
- 懂逻辑:能够进行多步骤的复杂推理
- 懂工具:能够高效地使用各种工具完成任务
- 懂协同:能够协调多个子 Agent 并行工作
这些都是通用基座模型带来的能力。如果从头训练一个"只懂法律"的小模型,它在法律知识上可能很强,在需要编写代码搜索文档、使用工具完成复杂工作流时就会力不从心。
正确的做法是 Harvey 的做法:
- 选择一个通用能力极强的开源基座(如 Kimi K3、DeepSeek V4、Qwen3.8)
- 在基座上进行垂直领域的后训练(保留通用能力,增强垂直能力)
- 训练专家子模型处理特定类型的任务
- 在垂直 Agent Harness 中部署,配合专属工具集
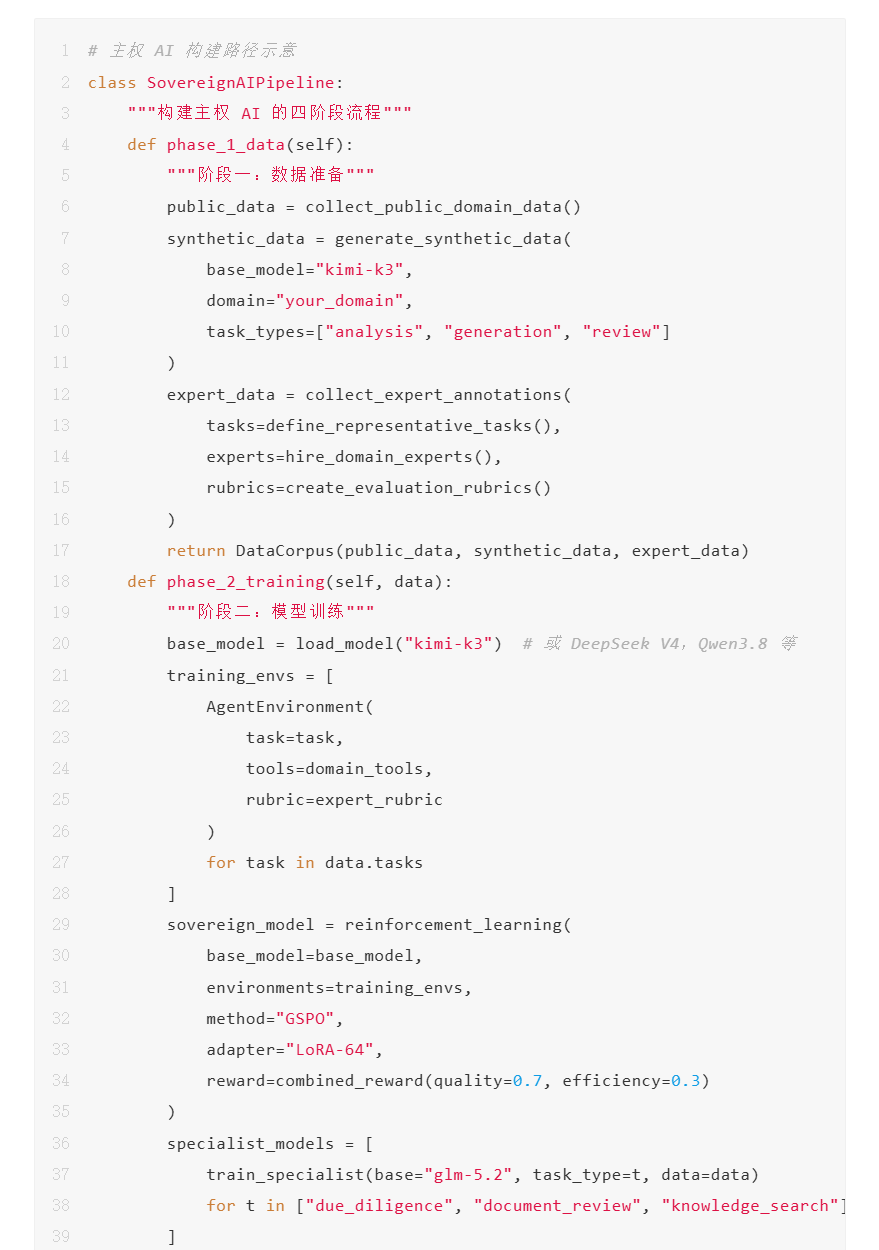
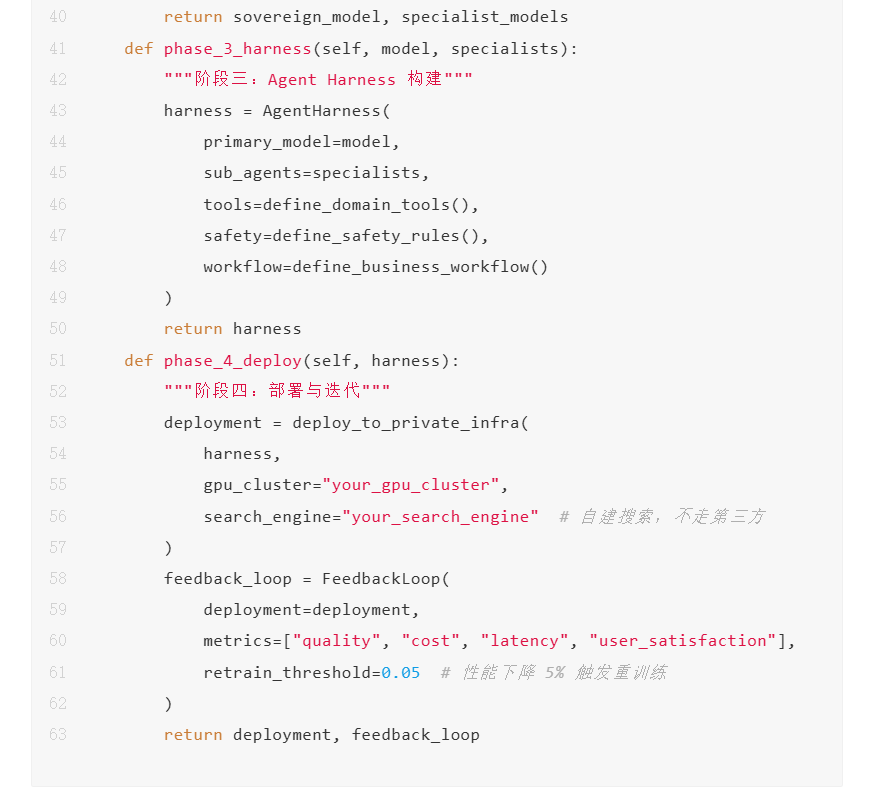
2. 一个实际的实施路径
对于一个想要构建主权 AI 的公司来说,实施路径大致如下:
为什么是现在?三个力量的汇聚
主权 AI 的概念并不是全新的,现在是它从理念变为实践的关键时刻。三个力量在 2026 年同时汇聚:
力量一:开源基座模型的成熟
Kimi K3、DeepSeek V4、Qwen3.8,GLM 5.3 等模型证明,开源基座的通用能力已经达到了可以支撑垂直后训练的水平。Harvey 选择 Kimi K3 而非自行预训练,就是这种信心的体现。
力量二:Agent 平台的开放
DSH,OpenAI 将 Codex Harness 开源,Anthropic 开放 Claude Code Function Hooks,这些决策降低了构建垂直 Agent 的门槛。你不需要从零构建 Agent 运行时,只需要在成熟平台上注入自己的业务逻辑。
力量三:安全意识的觉醒
从 Meta 自建搜索引擎到字节自建搜索引擎,从 Harvey 自训主权模型到红杉资本合伙人公开呼吁,行业正在形成共识:依赖闭源模型 API 不仅是成本问题,更是生存问题。
这三个力量的汇聚,使得主权 AI 从"锦上添花"变成了"生存必需"。
挑战与路径:不是每家公司都需要 150 块 B300
主权 AI 并非没有挑战。Harvey 使用了 150 块 NVIDIA B300 训练了 2 个月,这不是每家公司都能承受的投入。好消息是,训练基础设施正在被平台化。
Fireworks AI 在 2026 年 8 月正式发布了 Training API 和 Fireworks Lab,让企业无需自建 GPU 集群就能进行模型后训练。Harvey 的 Tenet 正是在 Fireworks 平台上完成训练的,这证明了平台化方案的可行性和效果。
主权 AI 的实施有很多选择:
1. 轻量级主权(小团队 / 初创公司)
开源基座 (Qwen3.8-7B/Llama 4-8B)
+ SFT / DPO 微调 (数百 GPU 小时)
+ Codex Harness / Claude Code Hooks
+ 自定义工具集
= 垂直 Agent 解决方案
成本:数千到数万美元
适合:有明确垂直场景的初创公司
2. 中量级主权(中型公司 / 垂直 SaaS)
开源基座 (Kimi K3/Qwen3.8/GLM5.3/DeepSeek V4 flash)
+ RL 后训练 (数千 GPU 小时)
+ 自建 Agent Harness
+ 专家子模型
= 企业级垂直解决方案
成本:数十万美元
适合:有专业数据和领域专家的垂直 SaaS 公司
3. 重量级主权(大型企业 / 行业领导者)
开源基座 (Kimi K3/Qwen3.8/DeepSeek V4 pro)
+ 大规模 RL 后训练 (数万 GPU 小时)
+ 多个专家子模型
+ 自建 Agent 平台
+ 自建搜索引擎
+ 自建推理基础设施
= 全栈主权 AI 平台
成本:数百万到数千万美元
适合:Harvey、行业巨头、金融机构、政府部门
关键在于:你不需要一步到位。可以从轻量级开始,随着业务增长和数据积累逐步加深主权程度。
展望:通用智能与垂直智能的融合
回顾整篇文章的逻辑链条:
- 开源模型能力过关 → 可以作为主权模型的基座
- 成本大幅降低 → 经济上可行
- 数据安全成为刚需 → 战略上必要
- Agent 平台开放 → 技术上可行
- 行业共识形成 → 生态上支持
这五个因素共同指向一个结论:你的公司也需要考虑业务数据的安全,拥有主权AI。
未来的 AI 应用格局将是这样的:
- 少数几家公司提供强大的通用开源基座模型(OpenAI、Anthropic、Google、阿里、DeepSeek 等)
- 每个垂直领域的领导者基于这些基座训练自己的主权模型
- Agent Harness 成为新的平台层(如同当年的操作系统或浏览器)
- 数据安全和业务安全从"可选"变为"标配"
正如 Sonya Huang 所说,每一个 AI 应用公司都应该有自己的主权 AI 模型。不是因为炫技,不是因为 NIH 综合征(Not Invented Here),而是因为在 Agent 时代,模型就是业务,思考就是护城河。
拥有自己的主权 AI,不是一个技术选择,而是一个生存选择。
参考文献
- Y Combinator - Ollama CEO Interview (Lightcone Podcast)
- Harvey - Introducing Tenet
- Sonya Huang, Sequoia Capital - How Companies Are Building Their Own Intelligence
- levelsio - Meta Building Own Search Engine
- OpenAI - Codex as a Platform
- Claude Fast - Claude Code Function Hooks
- Fireworks AI - Training API & Fireworks Lab GA
- Codex as a Platform: Building Software Around the Open Agent Harness