网心科技 | DeepSeek V4.1 架构解读:从 Agent 到推理瓶颈到架构创新
直到 Technical Report 《DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression》公开前,一直以为 V4.1 是一个 V4 的后训练版本,看了报告才知道 V4.1 是一个全新的架构。这篇文章要回答三个问题:
- V4.1 为什么要长成现在这样的架构?
- 它为什么能往这个方向改?
- 改完的效果为什么好到可以进一步 scaling?
我们从什么是基于语言模型的 Agent 说起...
基于语言模型的 Agent 到底是什么
基于语言模型的 Agent,实际上就是一件事:交给语言模型一个没有明确过程的目标,让它不断思考、不断跟环境互动并得到环境的反馈,基于这些反馈继续思考,loop 直到最终解决这个问题。
这个过程可以用如下图示来解释:
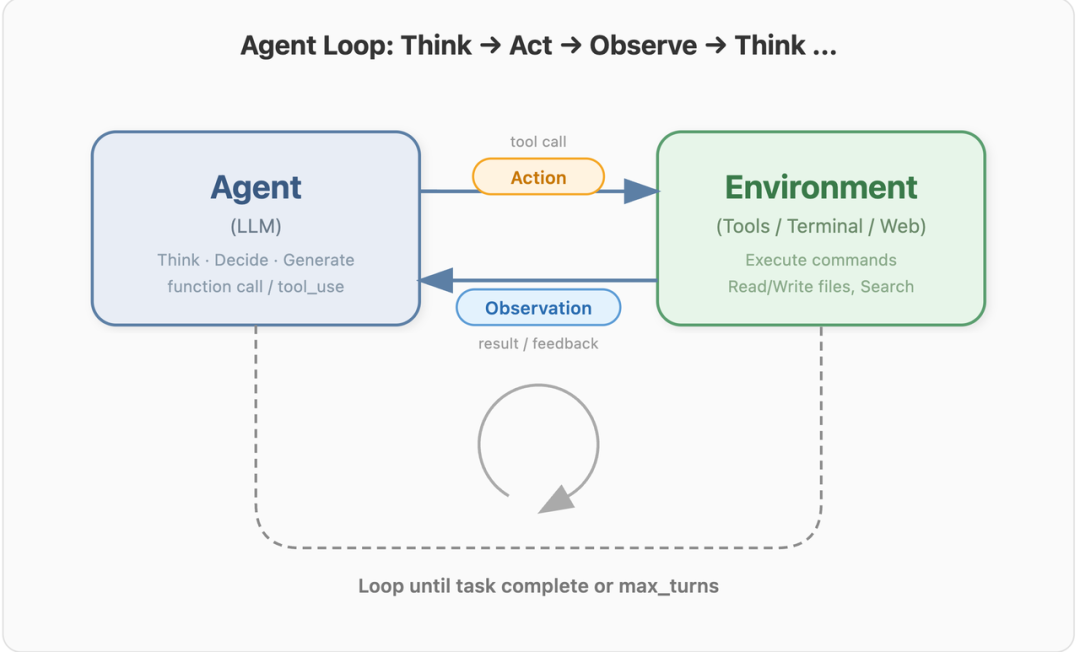
Agent 通过跟 environment 互动,执行一系列动作(比如写文件、执行命令、搜索网络),得到文本的结果返回(编译结果、搜索结果、执行输出)追加到Agent的上下文,以这个新的上下文文本发送给LLM,让它推理并做出下一步决策,最终解决问题。
下面是一段简化的 Python 示例代码,模拟这个 Agent 循环。它的结构与 Claude Code、DeepSeek 的 coding agent 或任何 function-calling agent 本质上是一样的:
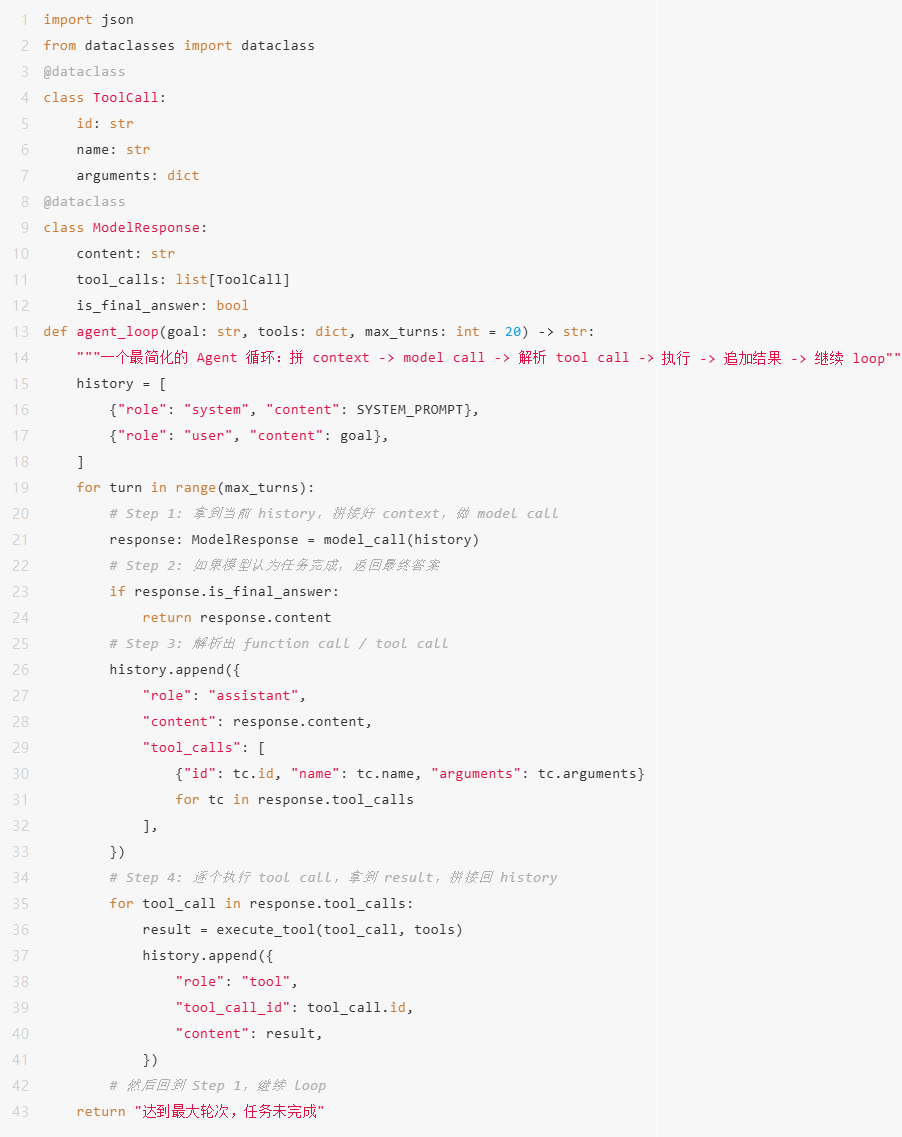
整体流程非常清晰:
1. 拿到一个问题,拼接好 system prompt 和 context,调用模型
2. 模型经过推理,返回一些内容,包含工具调用
3. 解析出现在要做哪些工具的调用
4. 执行工具,拿到返回的结果
5. 把第4步的结果拼接回 history,然后继续做这个 loop
6. 直到模型判断任务完成,或达到 max_turns 退出
Agent 上下文是怎么膨胀的
让我们来看一个实际的例子:写一段 Hello World
假设用户的目标是"用 Rust 写一段 Hello World 程序并通过编译"。整个 Agent 循环可能会是这样的:
第 1 轮:
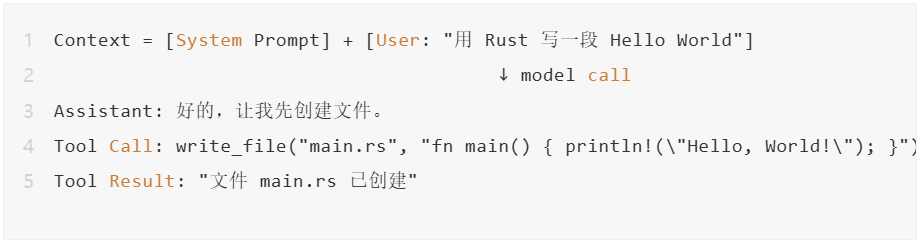
第 2 轮:
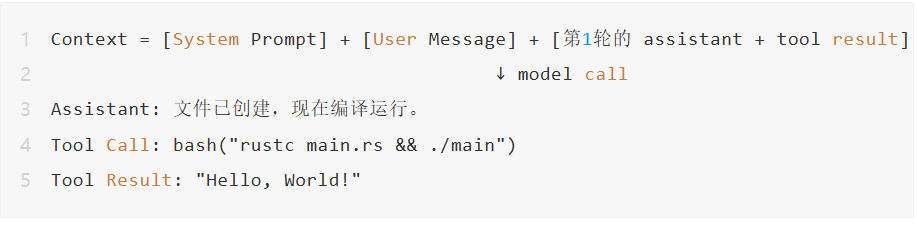
第 3 轮:
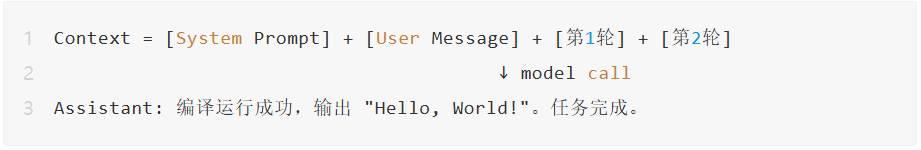
这是一个理想情况。但在真实场景中,事情往往更复杂。比如用户要求的是一个带依赖的项目,编译时拿到了 compiler error,需要把错误信息贴回去让模型纠正,然后再编译、再测试。每一轮 tool call 的返回可能包含大量日志、错误堆栈、测试结果。上下文在这个过程中会快速膨胀。
用下图来展示一下 context 的结构变化:
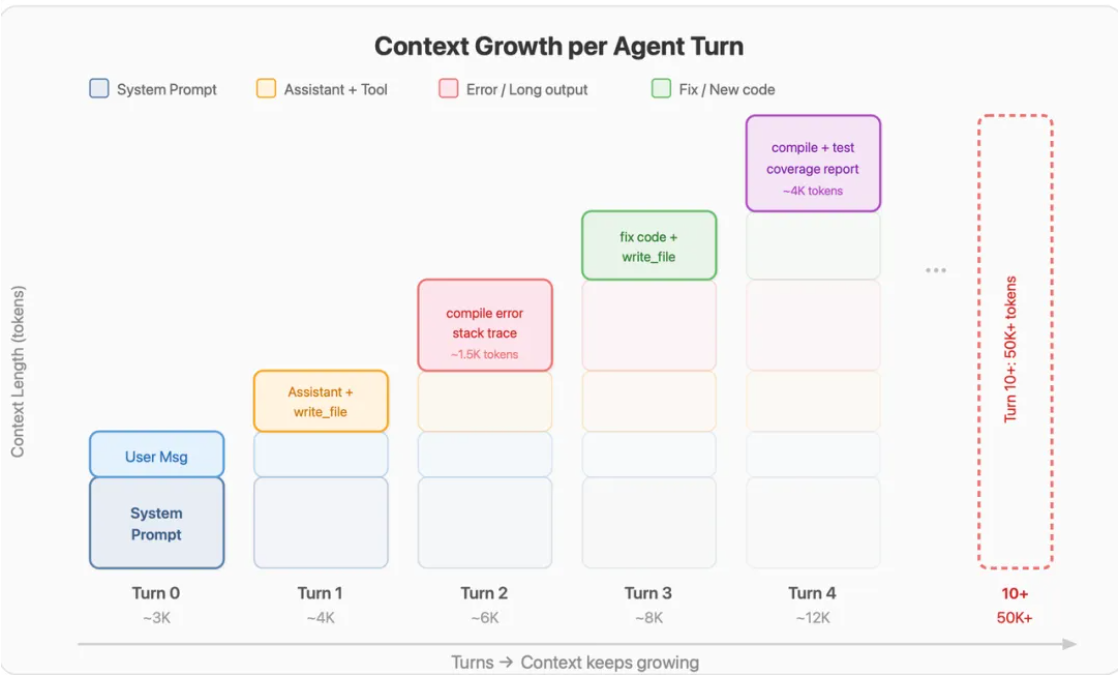
关键问题来了:当这个逐渐膨胀的上下文到达推理引擎时,到底会发生什么?
长上下文到达推理引擎会发生什么
以下的讨论都基于如下图的推理集群架构讨论
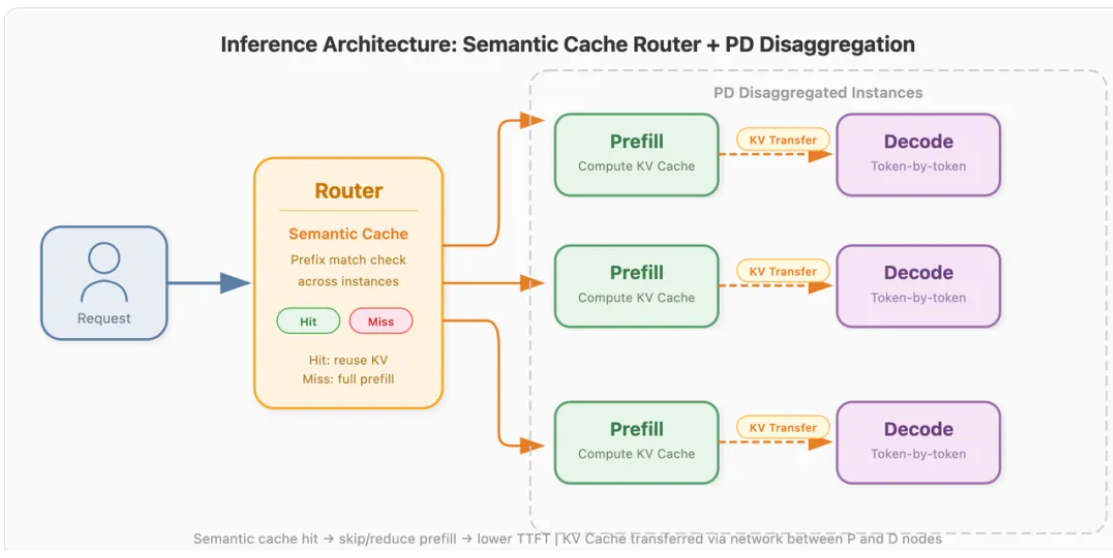
请求首先到达 Router,然后是路由给不同的推理实例来服务。下面都假设 Router 能正确的让同一个任务的对话都最大可能的用一个实例服务,也就是 KV Cache 的命中率很高。
Prefill:首字时间的重要组成部分
当请求进入推理引擎后,模型通常先执行 prefill:处理尚未缓存的输入 token,生成对应的 KV Cache,并根据最后一个输入位置的输出计算首个生成 token 的概率分布,再得到首个 token。
如果没有可复用的 KV Cache,就需要处理完整输入上下文。多轮 Agent 调用可能使上下文增长到几万甚至几十万 token,从而增加 prefill 的计算量和内存需求。
如果命中前缀缓存,则可以跳过已缓存前缀的重复计算。但新增 token 仍然需要关注历史上下文,因此缓存复用并不意味着后续 prefill 的成本与历史长度无关。
长上下文 prefill 可能耗时数秒甚至更久,用户感知的 TTFT(Time To First Token,首 token 延迟)可以粗略拆解为:
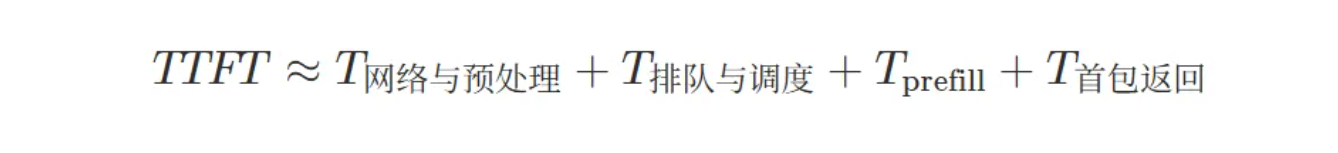
在高并发下,即使单个请求的 prefill 计算速度不变,排队与调度等待也可能明显推高 TTFT。如果 prefill 被切分执行,其间的调度等待同样计入 TTFT。
因此,分析首字时间时,需要分别观察计算耗时和等待耗时。
排队论视角:增大 batch 为何不能无限缓解等待
一个自然的问题是:能否把多个请求组成大 batch,一起处理?
答案是可以,而且 batching 是提高推理吞吐的重要手段。尤其当单个请求不足以充分利用硬件时,合并请求通常能够提高 GPU 的执行效率。
但 batching 的收益存在上限。当一个或少量长上下文请求已经使 GPU 接近有效计算吞吐上限时,继续增大 batch 的额外收益往往会减小。新增请求仍然带来更多计算和 KV 内存需求,batch 的执行时间通常也会增长。
Batching 可以提高处理效率,但不能消除新增请求所需的工作量。
为了理解排队现象,可以把一个具有固定服务能力的 prefill 执行单元,近似看作先到先服务的单服务台。在到达和服务过程满足相应假设、系统稳定的条件下,G/G/1 队列的 Kingman 近似为:
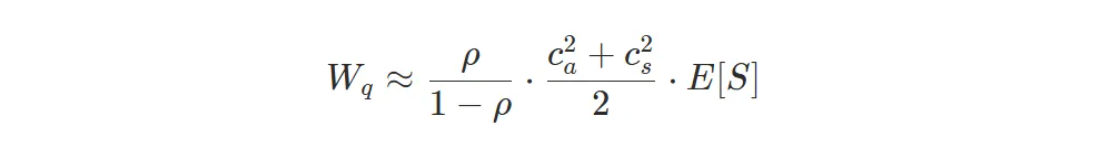
其中:
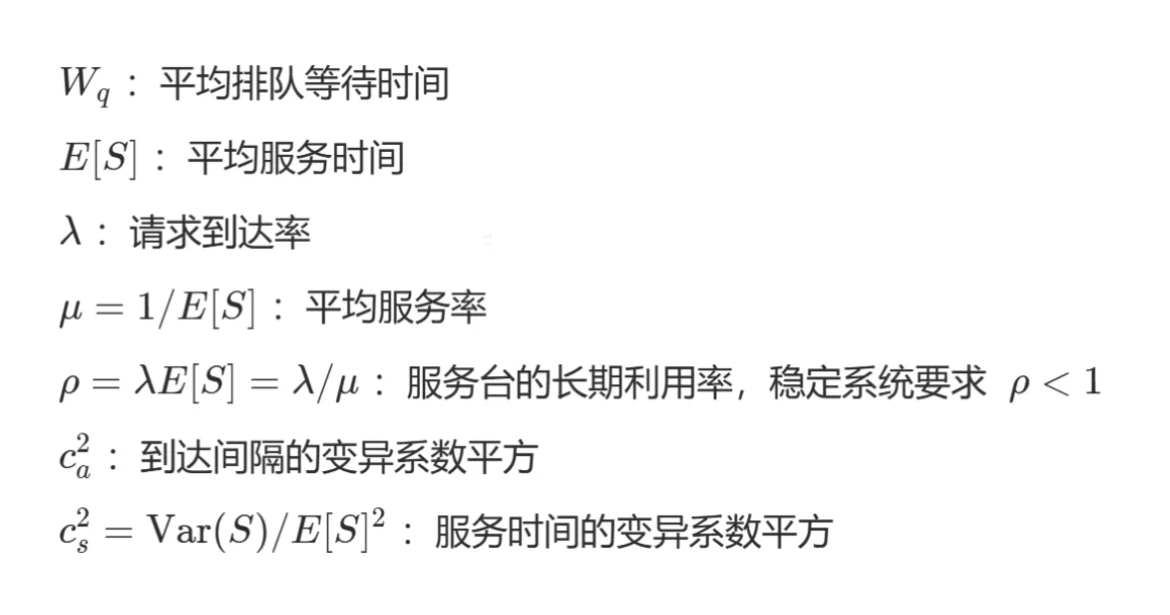
这个公式提供了三个重要启示
第一,随机负载下,长期利用率越接近 1,排队延迟通常增长得越快。
当其他条件保持不变且变异项非零时,随着 ρ 接近 1,ρ/(1-ρ) 会急剧增大。
这里的利用率是长期平均意义上的负载与容量之比,不能用某个请求运行时的 GPU 瞬时占用率代替。一个长请求可以在执行期间充分使用 GPU,但如果请求到达很稀疏,系统的长期利用率仍然可能很低。
第二,平均服务时间和服务时间波动都会影响等待时间。
在到达率不变时,平均服务时间增加,不仅直接增加公式中的 E[S],还会提高 ρ,进一步放大等待时间。在平均服务时间和其他条件相同时,更大的服务时间变异也会增加平均等待时间。
Agent 场景下,不同轮次的上下文长度、缓存命中情况和计算需求可能不同,从而增大服务时间的波动。
第三,请求到达的波动同样重要。
即使平均请求量没有变化,集中到来的突发请求也可能形成较长队列。因此,不能只看平均 QPS 和平均 prefill 耗时,还需要关注流量突发程度及服务时间分布。
真实 LLM serving 的适用边界
真实的 LLM serving 往往采用多副本、动态 batching、分块 prefill,以及 prefill/decode 共享或分离等机制。请求的服务时间还会随 batch 组成、调度策略和资源竞争而变化。
分块 prefill 可以提供更细的调度机会,缓解长请求对其他请求的阻塞,但也可能增加执行开销,不保证所有请求的 TTFT 都得到改善。prefill/decode 分离可以减少两类计算之间的干扰,但不会自动消除 prefill 队列。
KV Cache:存储与传输的压力
即使通过语义 Router 把请求分发到正确的推理集群,使得 KV Cache 命中率很高。也就是说,之前轮次产生的 KV Cache 还在 HBM 中,没有被 evict,也还有一个问题:
不同用户的 KV Cache 需要共存于有限的 HBM 空间中。
高并发场景下,prefill 节点上可能堆积了大量用户的 KV Cache。即使把不活跃的 Cache换出到 system memory 或 SSD,也会占用大量存储空间,并且 reload 时的数据搬运还会消耗互联带宽。
总结一下,长上下文 Agent 场景给推理引擎带来了三重压力:
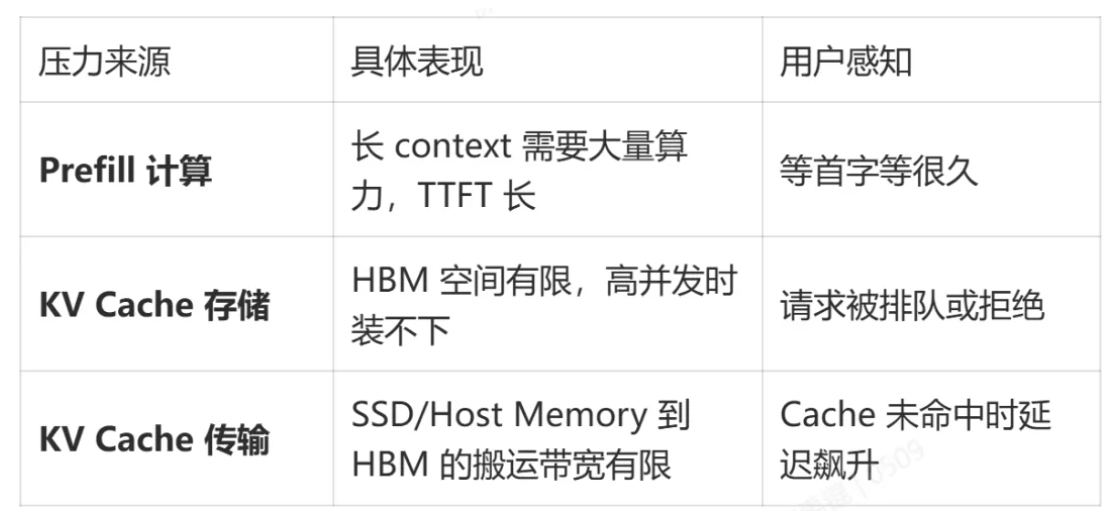
这就是 DeepSeek V4.1 要解决的核心问题:进一步降低计算开销,压缩 KV Cache 的存储占用,让 Agent 场景下的超长上下文推理真正可以 scale。
V4.1 的解法概览
DeepSeek-V4.1-Flash 是一个 552B 参数的多模态 MoE 模型,共 40 层 Transformer,原生支持最长 100 万 token 的上下文。它的核心改进是 架构层面 调整。
改进围绕两个核心目标展开:降低 Prefill 算力 + 压缩 KV Cache 存储。
CED(Causal Encoder-Decoder):Prefill 计算量减半
借鉴 YOCO(You Only Cache Once)的思想,V4.1 把 40 层 Transformer 拆成两半:
- 前 20 层 = Causal Encoder:负责处理完整的输入序列,产生全局 KV Cache
- 后 20 层 = Decoder:其全局 KV 不是自己层的隐状态产生的,而是由 Encoder 第 20 层的隐状态投影得到
这意味着 Prefill 时大部分 token 只需要经过前 20 层,激活参数从 16B(decode 时)降到 8B(prefill 时),Prefill 计算量接近减半。
CSA2(Compressed Sparse Attention 2):跨层 KV Cache 复用
CSA2 从三个维度压缩 KV Cache:
- 条目大小维度:用 512 维潜在向量共享表示各注意力头所需的 K 和 V(沿用 MLA)
- 序列维度:Encoder 中把相邻 2 个位置合并为 1 条缓存(压缩比 2:1),Decoder 保留逐位置条目
- 层维度(新增):多层共享同一份全局 KV,全网只保留 3 份 Encoder Cache + 1 份 Decoder Cache
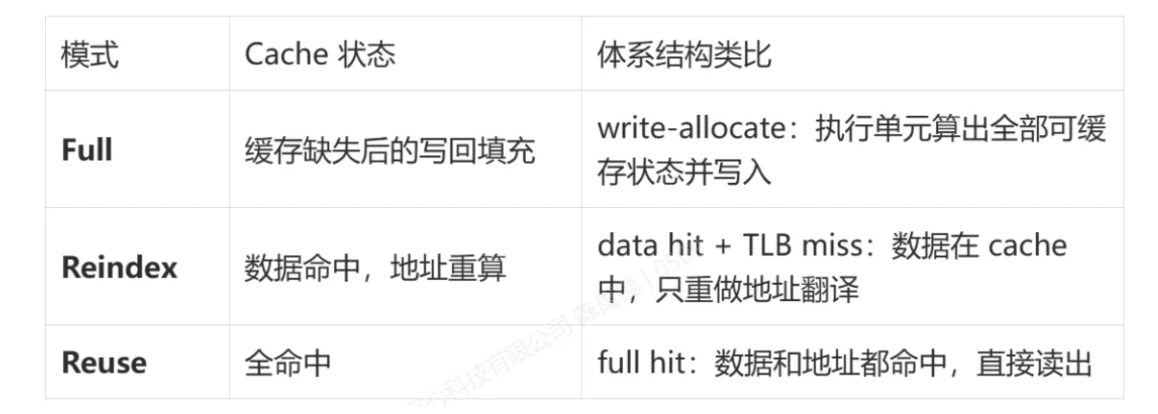
CSA2 定义了三种模式来实现跨层复用:
- Full 模式:新算 Main KV + Indexer K + Top-K indices(锚点层,写入缓存)
- Reindex 模式:复用 Main KV 和 Indexer K,重新计算 Top-K(数据命中,地址重算)
- Reuse 模式:全复用,只改写 Query(全命中)
FP4 量化:存储再减半
对 Main KV Cache 使用 FP4(E2M1)量化,每 16 个通道共享一个 E4M3 缩放因子,存储量接近在 FP8 基础上再减半。
其他关键改进
- Engram(N-gram 条件记忆):约 200 GB(FP8)的外部记忆表,通过 N-gram 哈希查表为模型补充短语模式信息,补偿 KV Cache 压缩带来的信息损失
- SWA Bounded Replay:限制 Decoder 滑动窗口注意力的重放范围,避免重放成本抵消 CED 的收益
- DSpark(投机解码):3 个额外的 SWA-128 草稿 block,加速 decode 阶段
最终效果
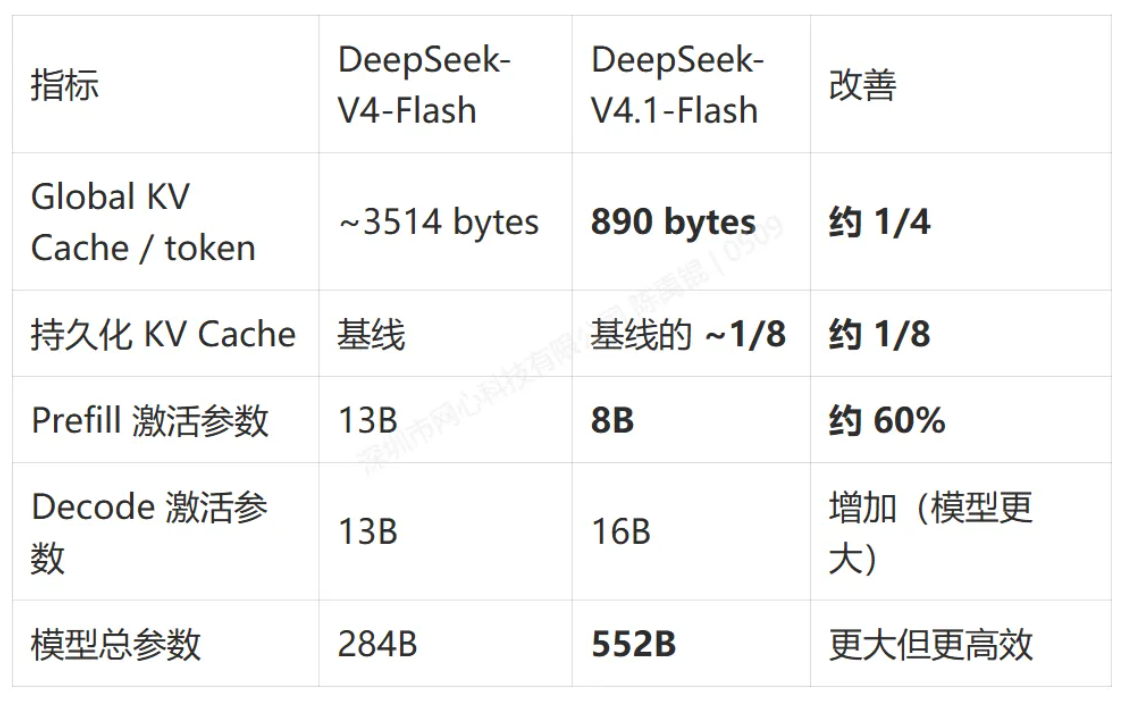
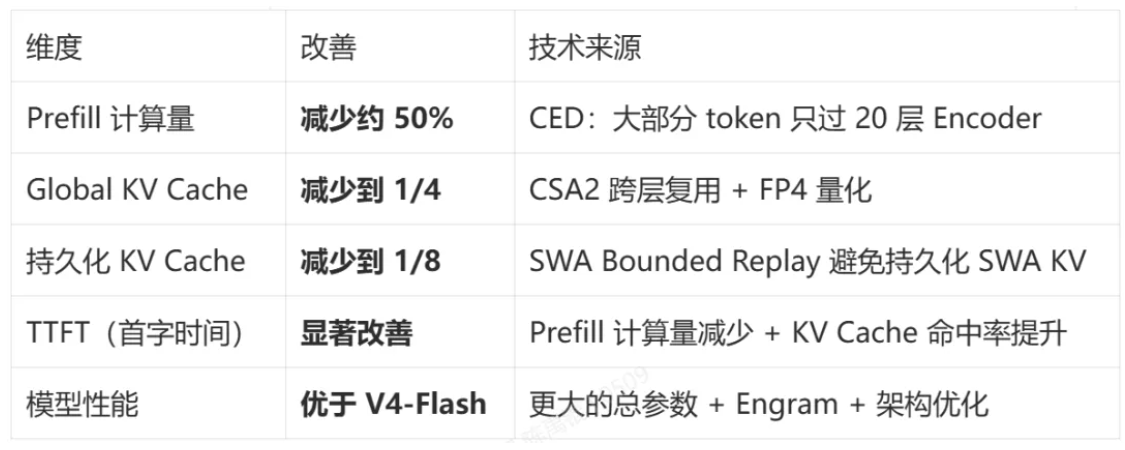
一个值得注意的反直觉事实:V4.1-Flash 的总参数是 V4-Flash 的近两倍,但 KV Cache 只有后者的 1/4,prefill 计算反而更少,且性能更好。 这就是架构创新的力量。
CED:为什么 Prefill 只需要一半计算
从 YOCO 说起
CED 的思想源自 YOCO(You Only Cache Once)这篇论文。YOCO 的核心洞察是:在标准 Decoder-Only 架构中,每一层都要为每个 token 计算并保存 KV Cache,这是 Prefill 效率低下的根源。
YOCO 提出了一个 Decoder-Decoder 架构,CED 在此基础上做了进一步改进:
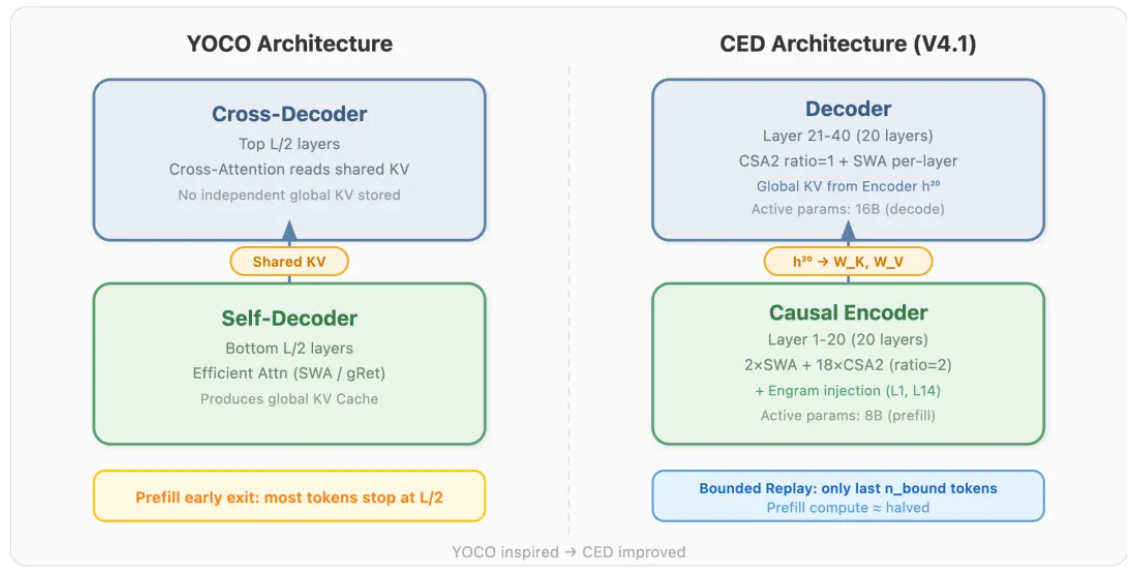
这个设计有两个关键效果:
1. KV Cache 只产生一次:前半部分产生全局 KV,后半部分复用,不再每层独立保存
2. Prefill 可以 early exit:大部分 prompt token 只需要经过前半部分就可以结束 Prefill,因为后半部分需要的 KV 已经由前半部分提供了
实际上这个方案在一些基模团队都有尝试,有时会用 "KV-Mirror" 这个名字来描述。腾讯的 WeLM 论文中就公开过类似的方案。
CED 在 YOCO 基础上做了什么
CED 在 YOCO 的概念之上引入了一系列结构改进。整个模型 40 层,分成两部分:
Causal Encoder(前 20 层):
- 第 1-2 层:纯 SWA(滑动窗口注意力,窗口大小 128)
- 第 3-20 层:CSA2(压缩稀疏注意力,压缩比 2:1)
- Engram 在第 2 层 SWA 之前和第 14 层之前注入
Decoder(后 20 层):
- 全局 KV 不由各层自己的隐状态产生,而是由 Encoder 第 20 层的隐状态 h²⁰ 经层相关的投影权重得到:
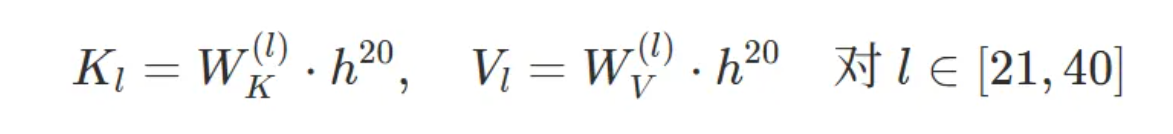
- SWA(局部窗口注意力)仍然逐层计算,保留了局部信息的深度
- CSA2 压缩比为 1(不做序列压缩,保留逐 token 可寻址性)
DeepSeek 换了一个观察角度来命名:YOCO 把两部分叫 Self-Decoder 和 Cross-Decoder,强调的是"怎样处理序列";CED 把它们叫 Encoder 和 Decoder,强调的是"它为后续网络提供什么"。名字不同,核心思想一脉相承。
为什么 SWA 需要 Bounded Replay
CED 让大部分输入 token 在完成 Encoder 计算后,无需继续经过 Decoder。Decoder 所需的全局 KV 直接由 Encoder 最后一层的隐藏状态投影得到,但各层 SWA 使用的 Local KV,仍需要由对应 Decoder 层的隐藏状态生成。
因此,提前结束大部分输入位置的 Decoder 计算后,还需要恢复供解码使用的局部缓存。
DeepSeek-V4.1-Flash 的 Decoder 有 Lᵈ=20 层,SWA 窗口大小为 w=128。只让最后一个窗口的 token 经过 Decoder,通常无法精确恢复深层 Local KV:这些位置在较浅层的计算,还会依赖窗口之外更早位置的状态。沿着逐层依赖向前展开,按照技术报告的计算,精确恢复需要重放最近:
Lᵈ x w = 20 x 128 = 2560 个输入 token。对于长缓存前缀后只新增少量输入的多轮调用,这部分 Decoder 重算开销可能相当显著。
为降低这一开销,DeepSeek 采用 Decoder SWA Bounded Replay:每次 prefill 只取整个输入末尾的 w=128 个 token,将它们的 Encoder 输出送入Decoder,并把重放期间的 SWA 访问范围截断在重放片段内。
具体而言,若重放从位置 b 开始,位置 i 的 SWA 只能访问:
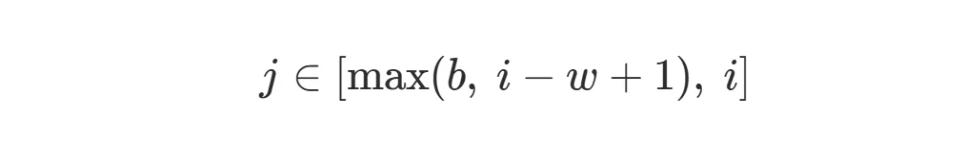
因此,重放片段开头的位置无法读取片段之前的 Local KV。恢复出的 Decoder Local KV 不与完整 Decoder 前向计算的结果数学等价。这些缓存仅供随后解码使用,不用于前缀缓存。这里的重放长度不是一个未指定的 n_bound,报告明确采用一个窗口,即 128 个 token。
在 Decoder 重放过程中,按 CED 架构构建的全局 KV 仍然可用。
V4.1 的技术报告中提到Decoder Bounded Replay 对回答质量的影响可忽略,并进一步在后训练中模拟相同的重放过程,让模型适配这一近似。同时,报告也承认,尚未测试的边界场景仍可能出现能力下降。
因此:该方案以近似的 Local KV,将重放范围从约 2560 个 token 缩短到 128 个 token,并在已评估场景中保持了回答质量。它不是具有普遍误差保证的精确恢复。
计算量分析:为什么接近减半
对比完整的 40 层计算与 CED 的计算量:
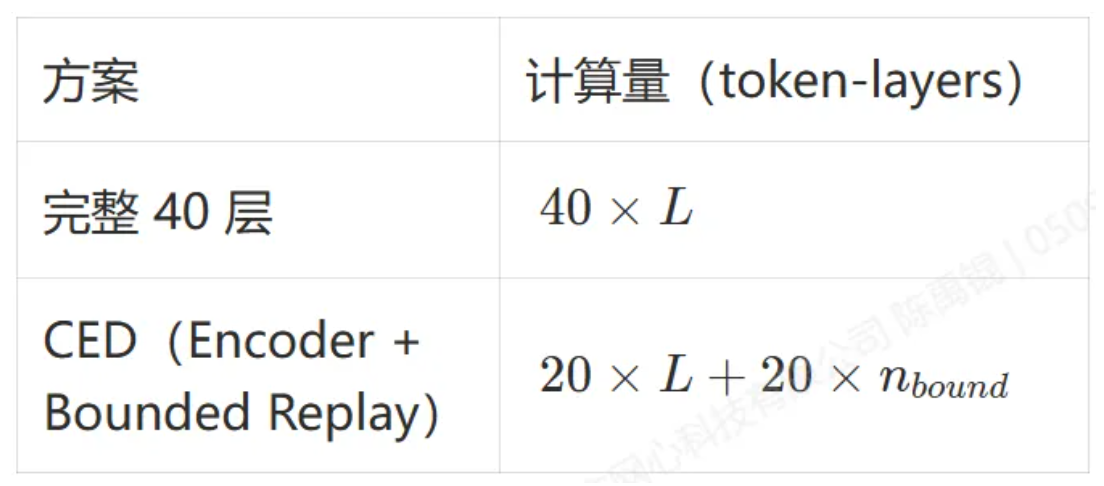
其中 L 是 prompt 长度,n_bound 是 Bounded Replay 的重放长度。
当 L ≫ n_bound 时,CED 的计算量接近 20L,是完整计算的约 1/2。
以 V4.1 的具体参数为例:Lₑ = Lᵈ = 20,w = 128。假设 prompt 长度 L = 100000:
- 完整计算:40 x 100000 = 4,000,000 token-layers
- CED:20 x 100000 + 20 x n_bound ≈ 2,000,000 + 小量 token-layers
- 比例:约 50%
CSA2:跨层 KV Cache 复用为什么能行
三个压缩维度
KV Cache 的存储成本可以沿三个具有乘法关系的维度压缩:
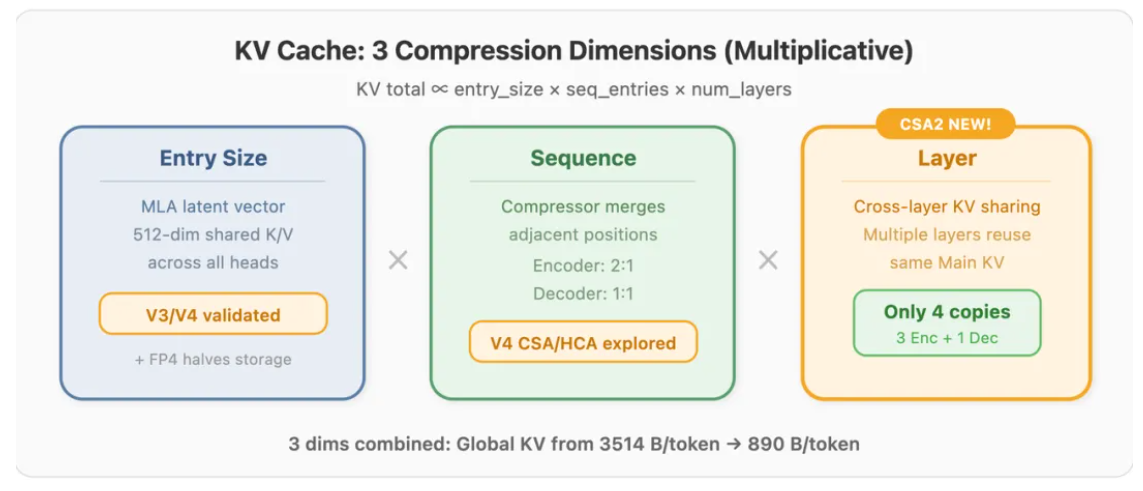
- 条目大小维度:MLA 用 512 维潜在向量共享表示各注意力头所需的 K 和 V,已经在 V3/V4 中验证
- 序列维度:Compressor 把相邻位置合并,Encoder 中压缩比 2:1,Decoder 中 1:1(不压缩)
- 层维度(CSA2 的核心贡献):多层共享同一份 Main KV,总共只保留 4 份
前两个维度在 DeepSeek V4 的 CSA 和 HCA 中已经有过探索。CSA2 的核心突破在于跨层复用。
三种模式的含义
CSA2 定义了三种模式来管理跨层的 KV Cache 复用:
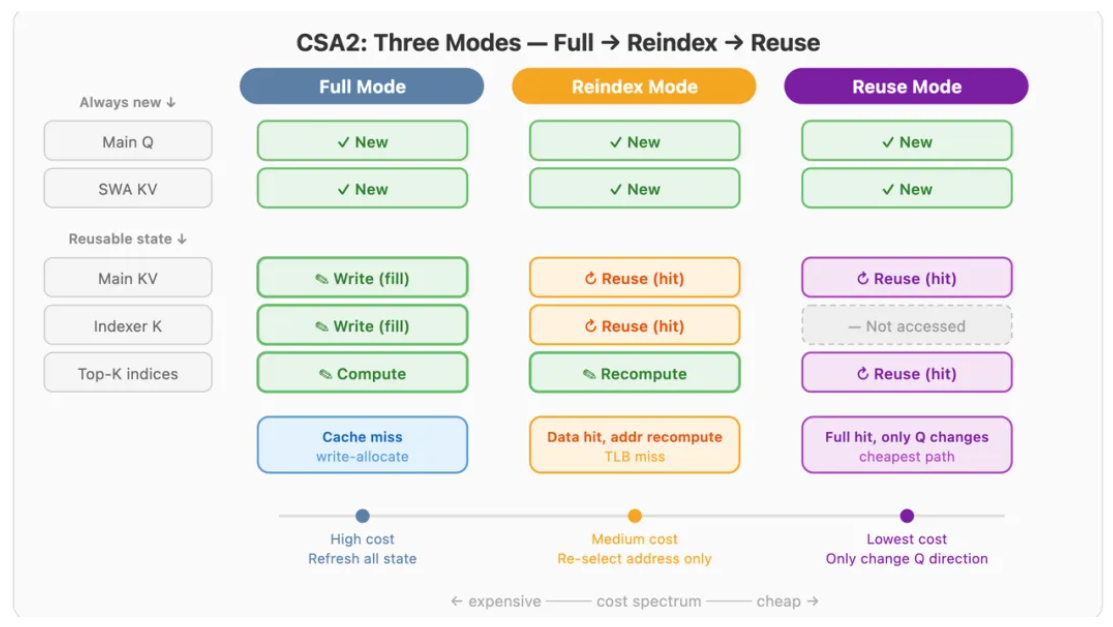
在所有三种模式中,Main Q 和 SWA KV 都是每层新算的。差异仅在于全局 KV 和索引的来源。在 V4.1 的具体配置中:
- Encoder:3 个 Encoder Block,每个 Block 由 1 层 Full + 5 层 Reuse 组成
- Decoder:1 个 Full Mode Block(layer 20-23)+ 4 个 Reindex Mode Block(layer 24-39)
为什么跨层复用能行:Attention 的跨层平滑性
这是整个 CSA2 设计能成立的核心前提。
如果 Attention 关系在各层之间是完全不变的,那么第一层计算完之后,后面所有的层按理都可以复用。但实际情况肯定不会完全不变。这里就涉及到怎么取舍。
关键观察:在训练好的 Transformer 中,相邻层的 Attention 权重分布通常是平滑的、偏连续的。也就是说,如果第 l 层对某个查询主要 attend 到位置 3、15、42,那么第 l+1 层对相似查询的 attention 分布不会突然跳到完全不同的位置集合。
反例场景:假设第一层的注意力集中在第 3 个 token 上,而第二层的主要贡献来自第 100 个 token,跟其他 token 关系都不大。那这样的差别非常大,复用的可能性就不存在了。
但实际训练出的模型中,这种极端跳变很少发生。相邻层更多的是在同一组候选位置上做权重的微调,而不是去关注完全不同的位置。
仅改写 Q 的表达力分析
zartbot 在其博客中给出了一个优雅的分析框架。对于 Reuse 模式(固定 Main KV 和 Top-K,只改写 Q),其注意力输出可以写成:
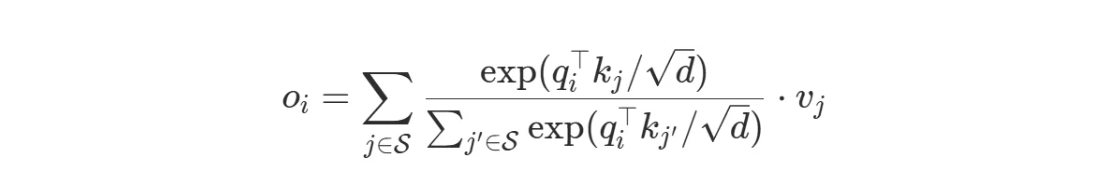
由于 CSA2 中 key = value(即 kⱼ = vⱼ),输出是字典向量 {kⱼ}ⱼ∈S 的一个凸组合。改写 Query 等价于在这个凸包内移动输出位置。
更精确地说,如果记基线查询为 q₀(来自 Full/Reindex 层),当前层查询为 q = q₀ + δ,那么:
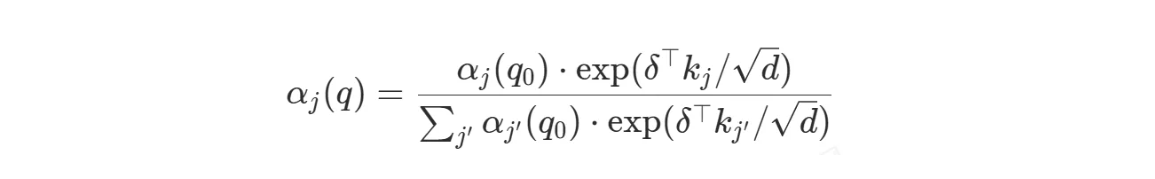
这是一个 指数倾斜(exponential tilting):扰动 δ 把基线分布沿某个方向做指数加权再归一化。这意味着:
- 仅改写 Q 可以把注意力质量压到单个条目(逼近某个顶点),摊平到均匀分布,或做任意软插值
- 共享 Top-K 不等于共享输出——同一组候选上可以有完全不同的权重分布
- 修改 Q 是全程可微的,不需要重新做 Indexer 打分和 Top-K 选择
- 由于 key = value,增大 δ 在某方向的投影会同时上调该方向 token 的权重并把输出拉向它,控制是直接且可解释的
Reuse 模式做不到的事情(与 Full 模式的差异):
1. 召回上限固定:如果某个关键内容不在 Top-K 选择集中,任何 Q 都访问不到
2. 顶点不可移动:输出被锁在固定凸包 conv({kⱼ}ⱼ∈S) 内,Full 模式改 KV 可以把输出放到凸包之外
3. 指数族固定:Reuse 的可达分布是由固定字典决定的指数族,Full 重选 KV 等于换掉整个族
但在实践中,这些差异被 "1 层 Full + 5 层 Reuse" 的配比有效地控制了。Full 层足够频繁地刷新字典和选择集,Reuse 层在此基础上通过 Q 的灵活调整完成精细读取。
计算机体系结构类比
如果把一层 CSA2 看成一台小计算机,三种模式就是同一套数据通路在三种缓存命中状态下的运行:
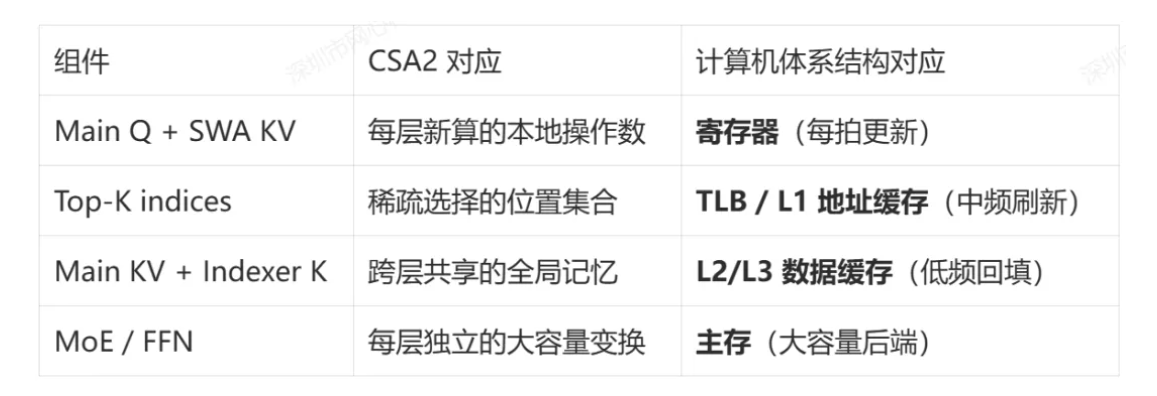
三种模式对应三种缓存状态:
CSA2 的 Indexer 对应 CPU 的地址生成单元(AGU)和 TLB:它不搬运数据,只产出"读哪些条目"的地址集合。主注意力是数据通路,按地址去共享缓存取 Main KV 再计算。
三个时钟域:CSA2 的三类状态实际上运行在三个刷新频率上:
- Query(寄存器级):每层更新,40 层刷新 40 次
- Top-K / 地址(L1 级):每 4-5 层更新一次,8 个 index source layers
- Main KV / 内容(L2/L3 级):每 6-20 层更新一次,4 个 kv source layers
越靠近执行单元刷新越快越便宜,越靠近共享后端刷新越慢越贵。CSA2 的模式调度就是把每类状态放到与其重算成本匹配的刷新率上。
HSI(Hierarchical Sparse Indexer):Decoder 中的优化
跨层索引复用减少了 Indexer 评估次数,但剩余的 Indexer 仍需对因果可见的全部上下文打分。对超长上下文,这一成本仍是主要计算瓶颈。
DeepSeek 引入 分层稀疏 Indexer(HSI),仅用于 Decoder:
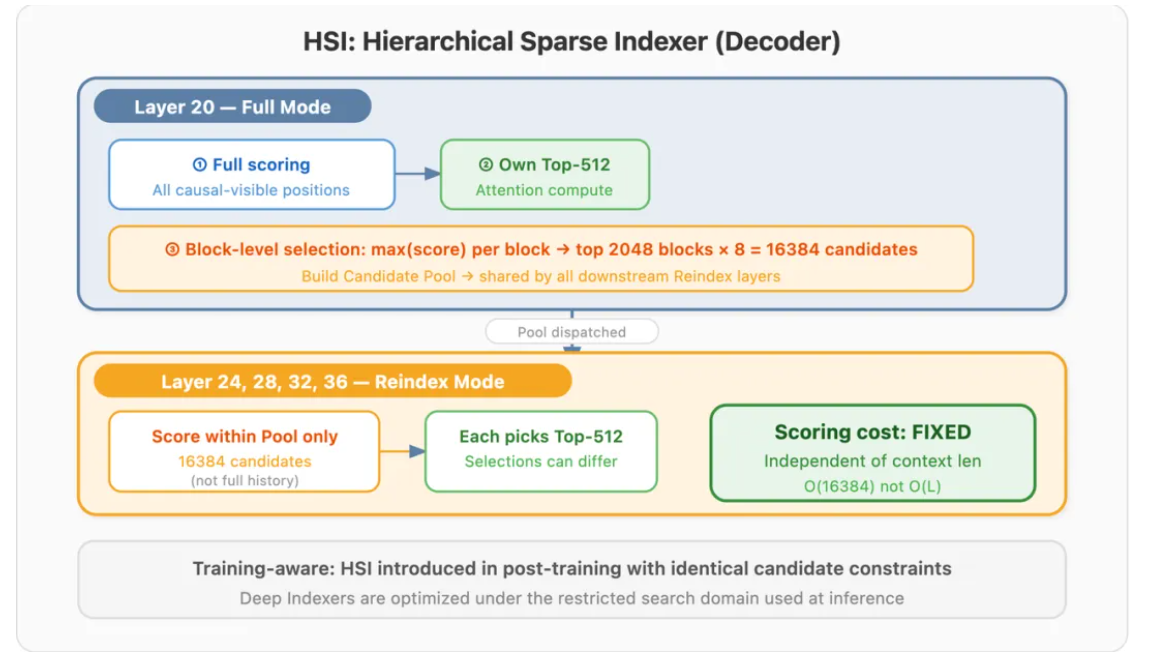
这样,除第一个 Full 模式层需要扫描全部历史外,后续所有 Reindex 层的打分成本都是 bounded,与上下文长度无关,只与候选池大小有关。
HSI 是训练感知的:在后训练阶段引入,训练与推理施加完全相同的候选限制,使深层 Indexer 在推理所用的搜索域下被优化。
KV Cache 为什么是 890 bytes/token
最后,让我们精确计算 V4.1-Flash 的 Global KV Cache 占用。
Global KV Cache 只保留在 4 个 KV Source Layer 上(Encoder 的 layer 2, 8, 14 和 Decoder 的 layer 20)。每层有两个组件:
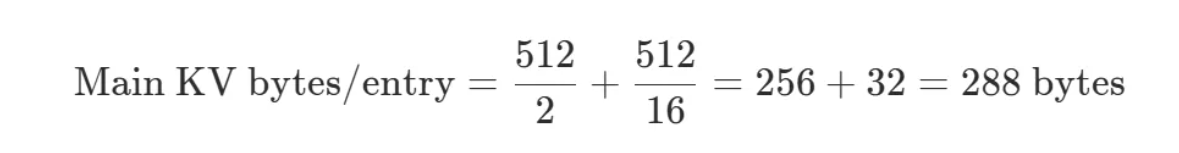
Main KV 条目(d = 512 维,FP4 量化):
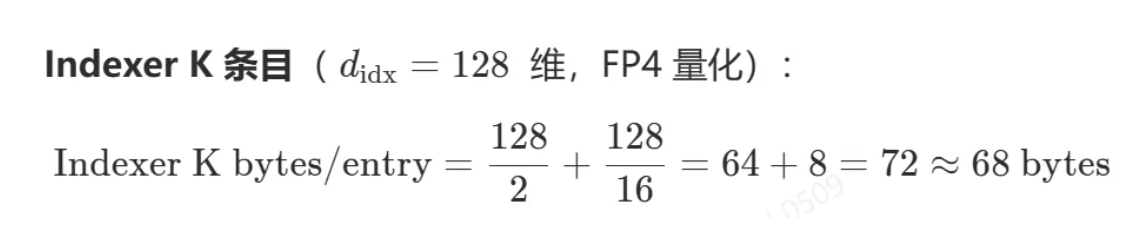
其中 FP4 每两个通道占 1 字节,每 16 个通道需要 1 字节的 E4M3 缩放因子。
实际值为 68 bytes,因为实现中的精确对齐有微调。再考虑压缩比。Encoder 层压缩比为 2(每 2 个 token 存 1 条),Decoder 层压缩比为 1(逐 token 存储):
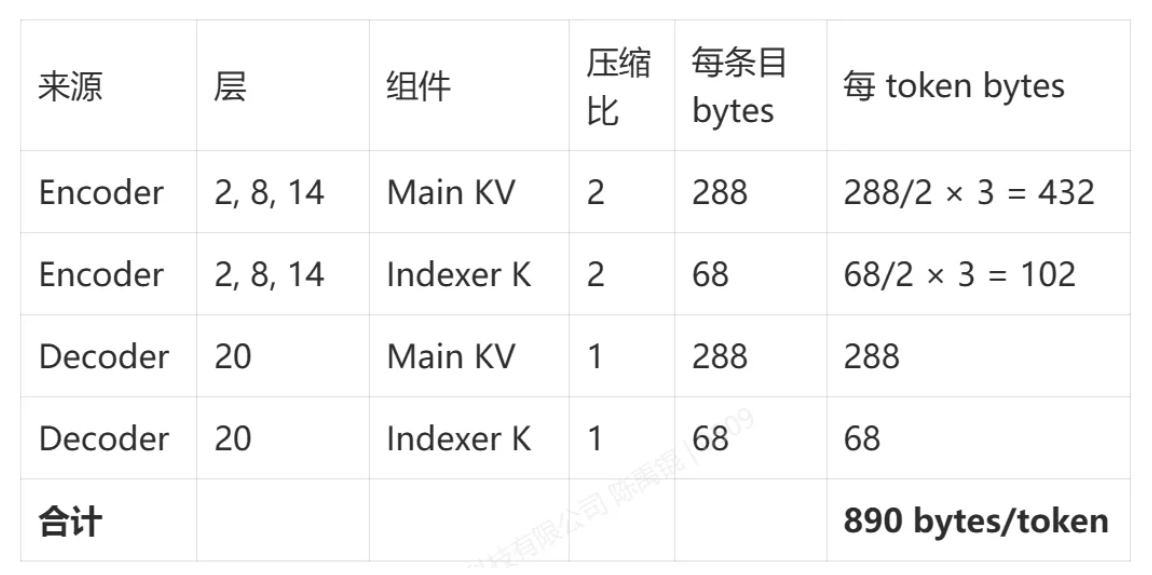
对比 DeepSeek-V4-Flash 的约 3514 bytes/token,V4.1 的 Global KV Cache 仅为前者的约 1/4。这个 890 bytes/token 意味着什么?以 1M token 上下文为例:
- V4-Flash:3514 x 10⁶ ≈ 3.3 GB(仅 Global KV,不含 SWA)
- V4.1-Flash:890 x 10⁶ ≈ 0.85 GB
在 HBM 容量有限的情况下,这个差距直接决定了能同时服务多少用户、能支持多长的上下文。
最终效果与 Scaling 展望
效果总结
DeepSeek V4.1-Flash 的架构创新并不是以牺牲性能为代价的压缩,它在大幅降低资源消耗的同时,性能优于 V4-Flash 基线。
为什么它可以进一步 Scaling
V4.1 的架构设计不仅解决了当前的瓶颈,更重要的是它打开了进一步 scaling 的通道:
第一,KV Cache 不再是存储瓶颈。
890 bytes/token 的 Global KV Cache 意味着即使在 1M token 上下文下,单用户的 KV Cache 也不到 1 GB。在 HBM 容量持续增长的趋势下,这为更长上下文和更高并发留出了充足的空间。
第二,Prefill 计算量下降释放算力给更多并发。
CED 将 Prefill 计算减半,意味着同样的 GPU 集群可以处理更多的并发请求。从排队论的角度看,E[S] 减半直接让 Wq 减半,ρ 降低又进一步通过 ρ / (1-ρ) 项带来超线性改善。
第三,Bounded Replay 让多轮对话的增量成本可控。
在 Agent 的多轮交互中,大部分历史已命中全局缓存,每轮新增的内容很短。Bounded Replay 把恢复 Decoder SWA 状态限制为固定开销,不随历史长度增长。这意味着 Agent 可以跑更多轮次而不会遇到计算成本爆炸。
第四,架构设计与训练方法协同演进。
V4.1 的多项创新是在不同训练阶段逐步引入的:
- 预训练阶段:从头使用稀疏注意力和 CED 架构
- 后训练阶段:引入 HSI 候选限制,使 Indexer 适应受限搜索域
- QAT(量化感知训练):引入 FP4 Main KV Cache
- DSpark 专门训练阶段:先冻结主干训练草稿模型,再联合微调
这种渐进式的训练策略意味着每个组件都在其最适合的阶段被引入和优化,而不是一次性堆叠所有技巧。
回到 Agent:为什么这些改进对 Agent 特别重要
让我们回到开头的 Agent 场景,看看 V4.1 的改进如何逐层解决问题:
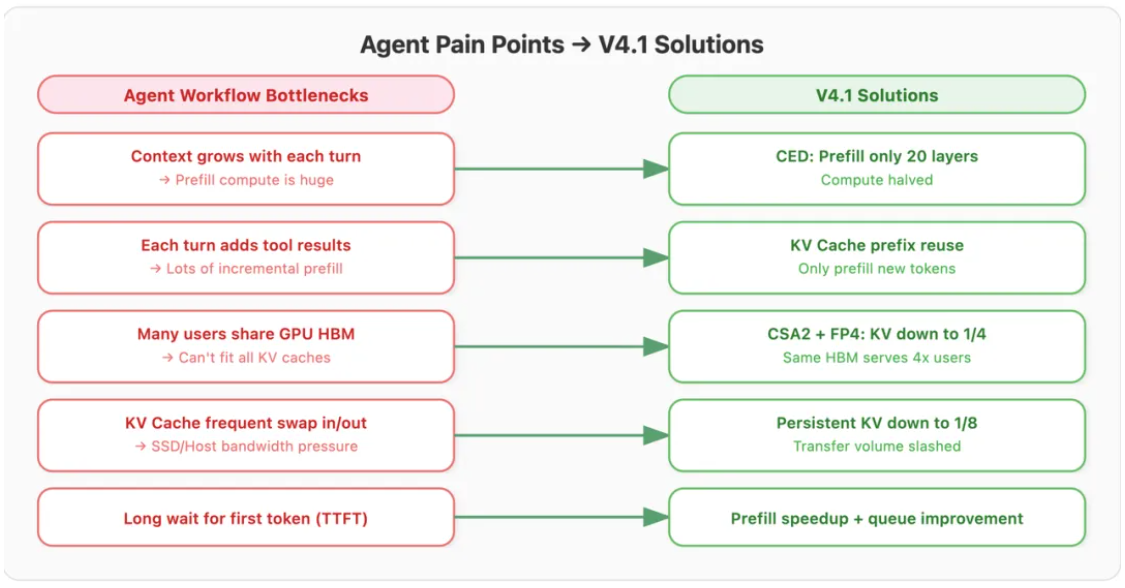
V4.1 论文 "Pushing the Limits of KV Cache Compression"。从 Agent 的视角来看,它真正推动的是超长上下文 Agent 场景的可扩展性边界。
当 prefill 不再是计算瓶颈、KV Cache 不再是存储瓶颈时,模型能力本身才真正成为首要的限制因素。而在 552B 参数和 Engram 条件记忆的加持下,V4.1 在这个限制因素上也交出了优于前代的答案。
参考文献
1. https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash/blob/main/DeepSeek_V41_Tech_Report.pdf
2. https://arxiv.org/html/2609.19969v1
3. https://arxiv.org/abs/2405.05254
4.https://zartbot.github.io/blog/model_arch/dsv41flash_arch/index.html
5. https://en.wikipedia.org/wiki/Kingman%27s_formula
6. https://jishuzhan.net/article/2089968124232613889
7.https://www.zhihu.com/question/2081380378493961583/answer/2081768662713754653
8. https://welm.weixin.qq.com/en/posts/building-effective-sparse-moe-models-with-moderate-resources/
9.https://proceedings.neurips.cc/paper_files/paper/2024/file/9e23d020c18e4c40d81c6a0fc7a46f68-Paper-Conference.pdf
10. https://arxiv.org/pdf/2603.28458v1